






现在开一场会,AI 录音设备几乎成了标配。市面上多数会议记录产品都能在几秒内生成一份像模像样的智能会议纪要,但真正需要邮件留痕会议纪要往往不能直接使用,散会后还得重听一遍录音来核对。
原因很简单,通用 AI 生成的纪要,因为没有用户的信息矫正和个性化信息输入,总是有各种各样的瑕疵错误。大模型降低了信息生成的门槛,同时也放大了信息失真的风险。过去语音转写的错误尚容易辨别,现在 AI 则会把语音识别出错的地方润色得通顺自然,几乎难以判断。
当然,这并非在否认 AI 的提效。拥抱 AI 是未来职场的大势所趋,但在把信任全盘交给 AI 之前,我们或许仍然需要思考,如何让一份会议纪要真正变得准确可信。
这也是讯飞办公本在最新一次版本升级中试图解决的问题。当多数办公工具还在比拼生成速度时,讯飞办公本试图从底层出发,重新审视 AI 的价值。它要解决的不仅是如何更快地生成一份会议纪要,更要具备足够的准确与可信。
转写生成只要十秒钟,回听纠错需要一小时
语音转写错误再常见不过了。动辄几个小时的会议录音,偶尔几个字词识别不清不算什么大问题。过去参会者对照着会议录音,结合上下文往往也都能识别出来,无非是多花一些时间。
但现在情况变了,会议纪要几乎都由大模型直接生成。大模型会顺着错词把残缺的句子补全,或者把听错的术语想当然地扩写成一段逻辑自洽的解释。哪怕前端识别错漏百出,大模型依然能交出一份语句通顺、条理清楚的纪要,让人无从判断真伪。
最常见的事故是说话人和发言内容对不上。其实很多错误其实从收音那一步就注定了。手机的麦克风是为贴耳通话设计的,不是在会议桌上收音的;声音进来的时候已经打了折扣,后面的识别和生成只是在把这个折扣放大。
多人开会讨论方案时,甲和乙一前一后开口,却表达了截然相反的意见。手机在转写时没能分清两人的声音,AI 纪要就可能把甲反对某项业务的理由,直接安在赞成这项业务的乙头上,搞出张冠李戴的乌龙。
专业词汇出错也会影响整段内容。比如在科技、医药或者金融行业中,很多缩写词汇都有固定含义。前端语音转写一旦把某个缩写听成发音相近的普通词,后面的 AI 就会顺着错词往下发挥。比如原本聊的是某个 API ,纪要搞成了 IP ,驴唇不对马嘴。
总而言之,指望机器永远不出错可能只是一个幻想。语音识别和文字生成都依赖已有信息来判断最可能的结果,大模型的本质只是在预测下一个词。当环境越复杂,缺失的信息越多,AI 越容易用相近的词汇或上下文填补。
想要在职场环境中真正做到真实可信,我们就不太能仅仅依赖 AI。
先把人分清楚
多人会议是最难的语音场景之一。一句没说完就被打断、只说三五个字的短句、两三个人交叉发言——这些让人耳一听就明白的部分,对于机器来说很难处理。分不清的后果不仅是漏掉几个字,还会把甲的话记到乙头上。
这和市面上许多主打全自动生成的软件思路不太一样。在 AI 已经能快速产出长篇摘要的今天,科大讯飞选择先为准确负责。近期讯飞办公本推出的新版本升级,核心就是围绕更精准的记录展开。
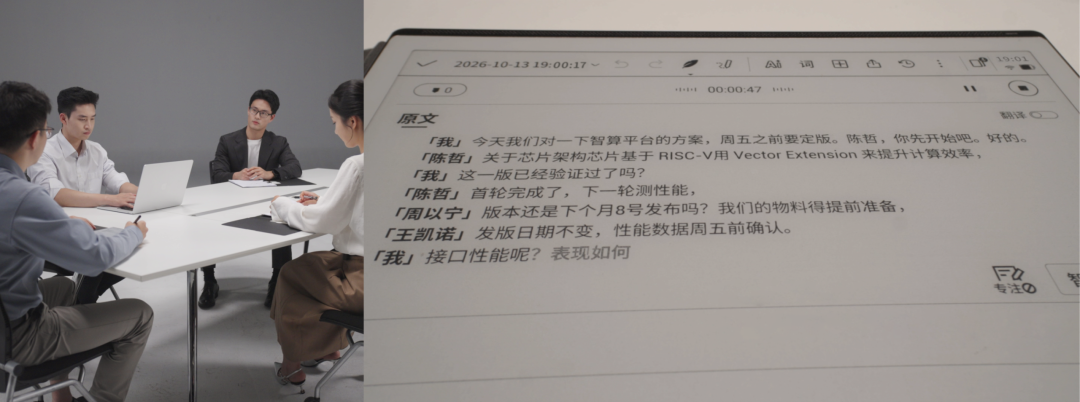
今年 1024 开发者节,科大讯飞发布了星火语音基座大模型 SparkAudio 1.0。这次升级的重点在多人场景下的分辨:谁在说、谁被打断、哪句是补充、哪句是重复,都要落到具体的人。这类问题靠算法调优解决不了,靠的是二十多年在真实会议、真实口音、真实对话里攒下来的数据。
新版本升级后,参会者在会上持续发言超过 15 秒,系统就会自动注册说话人声纹,用户同时可以把名字写上去。之后在其他会议中识别到同一声音,设备会直接显示已经确认过的姓名。
这项变化看起来只是省了一项会前准备,实际动的是记录的组织方式:过去要提前准备参会信息,现在会议途中顺手就把人对上了,且一经确认,此后每场会都直接显示姓名。注册这件事,从此不再需要单独做一次。
把话说准:术语、人名、人物关系
把人分清楚只是第一步。会议里还有一类信息不是听不清,是听清了也不一定判得对:一个缩写对应哪个英文单词,一个称呼指向哪位同事,两个人是汇报关系还是协作关系。这三类东西大模型能判断得很好,但也有它跨不过去的地方——因为它不在场,不知道你们公司内部管那位副总裁叫“老王”。
讯飞办公本的新版本升级中,新增“手写纠错”功能。这项功能相当于在正式生成纪要前,加了一道针对疑难信息的快速问答。
系统先把录音转写里拿不准的内容挑出来,生成几道简短的确认题,使用者直接拿手写笔写下正确答案,AI 再根据校准后的信息生成最终纪要。
手写纠错的逻辑,是把两部分判断分开:机器负责听、负责把拿不准的挑出来,人负责核对拿不准的信息。不是全文核对,只答它问的那几条。有些事大模型可以判断,有些不行,把不行的部分交“人”。
几次提笔确认,换来的是会后复核成本的大幅下降。对个人来说,散会后省去了戴着耳机逐句重听录音的时间,生成的纪要基本可以直接发进工作群。对企业而言,会议纪要没有了 AI 幻觉的烦恼,才真正具备了记录的价值。
确认过的东西会被记住。人名、岗位、术语,用得越久,它问得越少。再往后走,一篇纪要一次不改直接发出去,并不是不能想的事——但那是一步步确认换来的,不是模型自己变聪明。
攒下来,是为了能追溯
会议纪要的价值在于记录。企业在长期经营过程中,需要不断总结复盘,吸取失败教训,沉淀成功经验,逐步建立自己的方法论和知识库。
但问题在于,随着内部会议越来越多,纪要也越来越庞杂。许多文档一旦形成,会后就很少打开,最后只是作为按日期或项目归档的文件存在。
到了需要复盘的时候,团队通常只记得最终结论,很难还原中间的过程转变。尤其是在持续数月的长期项目中,某项决策为何调整、谁提出过不同意见,这些信息散落在几十份文档里,查找起来费时费力。
为了改变这种企业知识存储的固有弊端,讯飞办公本在知识库中上线了“人与观点”功能。已注册声纹的参会者可以建立独立的人物条目,系统会将人物在不同会议中的发言自动归集到同一页面。
过去要找一句话,得先想起是哪场会、哪个月、哪个项目,翻出纪要再从头看一遍。现在可以直接问:上次讨论定价的时候,老张是什么意见?它会把这个人历次相关的发言调出来。
按人整理记录,对发言归属的准确度要求更高。如果说话人识别出错,张冠李戴的言论就会直接污染整个知识库。前文提到的声纹自动注册与手写纠错,从源头上保证了录入信息的准确,这也是科大讯飞敢于更新知识库的技术底气。
这项功能改变了企业和个人使用历史记录的方式。对组织而言,按人检索资料,能从全局角度审视员工在项目各阶段的判断与贡献,对人才的识别和把握会更加准确。对个人来说,在长期参与大型项目之后,也可以借此从更长的时间周期回溯自身的成长和变化。
记录攒下来,不是为了让文件夹更厚,是为了下一次能问得出来。这是知识库和归档的区别——归档是存着,知识库是能答。
能不能带进去:为什么是端侧
还有一个问题比准确更关键:这台设备能不能被带进那间会议室。金融、法务、企业核心决策这类场合,数据保密不是加分项,是必须项。
讯飞办公本 X5 具备端侧处理能力。机身上有一个物理拨键,一拨就断网。不是“我们承诺不传”,是“它没法传”。依托设备内置的本地大模型与硬件算力,语音转写、分角色识别与纪要生成都可以在离线状态下完成。
这也是它和手机的分界。手机要接电话、要回微信,一场会里至少被打断几次;录到后半程,电量和发热也是实打实的问题。一台只用来记事的设备,带上去的心理负担反而更小,也更体面。
AI 时代并不缺少快速生成会议纪要的工具,稀缺的是散会后不用反复核对、事后经得起追问的会议材料。它记录的不仅仅是一次会议,也是团队每一次决策的来龙去脉,以及企业长期沉淀下来的业务资产。
讯飞办公本选择从实际出发,先将基础的精准记录做好,才能真正帮助职场人提效升级。也只有拥有了更准确、更真实可信的会议记录之后,团队的每一次决策才能做到有据可查、企业的每一次会议经验也都能沉淀复用。
尤其对于那些需要常常出席正式会议场合的商务人士来说,节省的不仅是反复核查信息的时间和心力,也是整个团队因信息失真而付出的沟通和决策成本。而且,正式场合本来也不适合把手机摊在桌上录音——讯飞办公本翻开是一本笔记本,配一支不用充电的笔,放在那儿不突兀。在正式场合,更可靠。
特别声明:本文为合作媒体授权DoNews专栏转载,文章版权归原作者及原出处所有。文章系作者个人观点,不代表DoNews专栏的立场,转载请联系原作者及原出处获取授权。(有任何疑问都请联系idonews@donews.com)


