



作者:高庆哲
编辑:吕鑫燚
出品:具身研习社
部分 VLA 模型走向实际部署时遇到的问题,是 “过拟合” 从一个训练阶段的技术卡点,变成了部署阶段的成本困境。模型在训练上表现出色,换个场景就失灵,因为它过拟合到了训练数据的物体摆放、光照和操作姿势分布。
要覆盖新场景,就得继续采集数据、继续训练,每覆盖一个新环境,就重走一遍数据到模型的流程。这也是世界模型逐步走向聚光灯的原因。
它承载的不是产业对 “新技术” 本身的期待,而是对改变这个成本结构的回应。
场景千变万化,但动作与物体之间的物理联系是通用的,抓一个杯子和拧一个灯泡,“先贴紧再施力”的接触逻辑是相通的。如果机器人能从数据中学到这些通用物理先验,遇到没见过的新场景,就不必从零开始采集数据,而是可以像人一样先在脑子里推演,不同动作会导致什么后果,哪条路径最可能走通。这是世界模型被寄予降本期望的底层逻辑,用预测能力替代一部分数据采集,用想象替代一部分试错。
但行业很快发现了一个问题:能预测未来,不等于能选对行动。
以拧灯泡为例,手感不对时,模型面前至少有三个选项:继续旋转(可能滑丝)、调整握姿重新发力(可能拧正)、稍作回退半圈(可能重新对准螺纹)。一个世界模型可以把这三条路径的后果都预测出来,但“预测出三种后果”和 “知道选哪一种”之间,隔着一个关键能力,判断哪一种后果更接近任务目标。没有这个判断能力,预演的未来再多,也只是一堆可能性的陈列,无法自动转化为行动。
这就是世界模型在具身落地时的核心矛盾,它擅长预演一束可能性,但机器人最终只能执行一条动作路径。
从 “可能性” 到 “执行路径”,中间需要一个收敛过程 ,预测每个动作的后果,评价哪个后果更接近目标,选出最优路径执行,再用执行结果反哺下一次决策。而这个收敛过程,大多数现有世界模型并不具备,它们能预测 “接下来会发生什么”,却回答不了 “这个接下来好不好”。
鸿沟由此清晰,模型即使能预测到一个可能失败的未来,也未必有机制主动避开它。
生数科技最新发布的 Motus2,瞄准的正是这道鸿沟。这款面向灵巧操作的自进化通用世界模型,在同一个参数共享的模型里做了三件事:生成候选动作、预测每个动作的视觉后果、给后果打分判断任务推进程度。机器人不再只是 "预演未来",而是能横向比较不同动作的预期结果,选出最可能成功的那条执行。更关键的是,这个打分信号会在后训练中通过基于模型的强化学习反馈给策略,下一次生成候选动作时,好动作的概率更高,坏动作的概率更低。
从 “预演可能性” 到 “利用可能性改善行动”,Motus2 试图补上的,正是这个闭环。
世界模型预测得准不准,取决于它见过多少真实的物理交互。进一步细化到灵巧操作来说,这个建模的起点不是模型架构,是数据,机器人用什么样的身体操作,决定了它需要什么样的操作经验。
Motus2 部署在单手 22 自由度的 Sharpa Wave 和单手 20 自由度的 WUJI Hand 2 上。让这些高自由度灵巧手真正用起来,首先遇到的不是动作怎么输出,而是操作经验从哪里来。
行业内的常见做法是围绕目标机器人采集遥操作示范,再针对具体任务训练。这种方式的好处是数据与本体直接对齐,但瓶颈也很明显,真机采集的规模受限于设备、人力和时间,每扩展一个任务场景,就要重新走一遍采集到训练的流程。灵巧手尤其如此,高自由度意味着动作空间巨大,靠真机数据覆盖全部操作类型,成本不可持续。
人类第一视角操作视频提供了一个量级完全不同的经验来源:场景广、任务多、手 - 物交互丰富。但人类视频不能直接拿来训练机器人,中间隔着三道鸿沟, 人类手和灵巧手的形态不同,人类动作的关节表达和机器人控制空间不同,单目视频缺少精确的空间深度信息。人类经验要变成机器人的执行能力,需要一座桥。
Motus2 搭的这座桥,是一套从人类经验到机器人本体的分层数据金字塔。
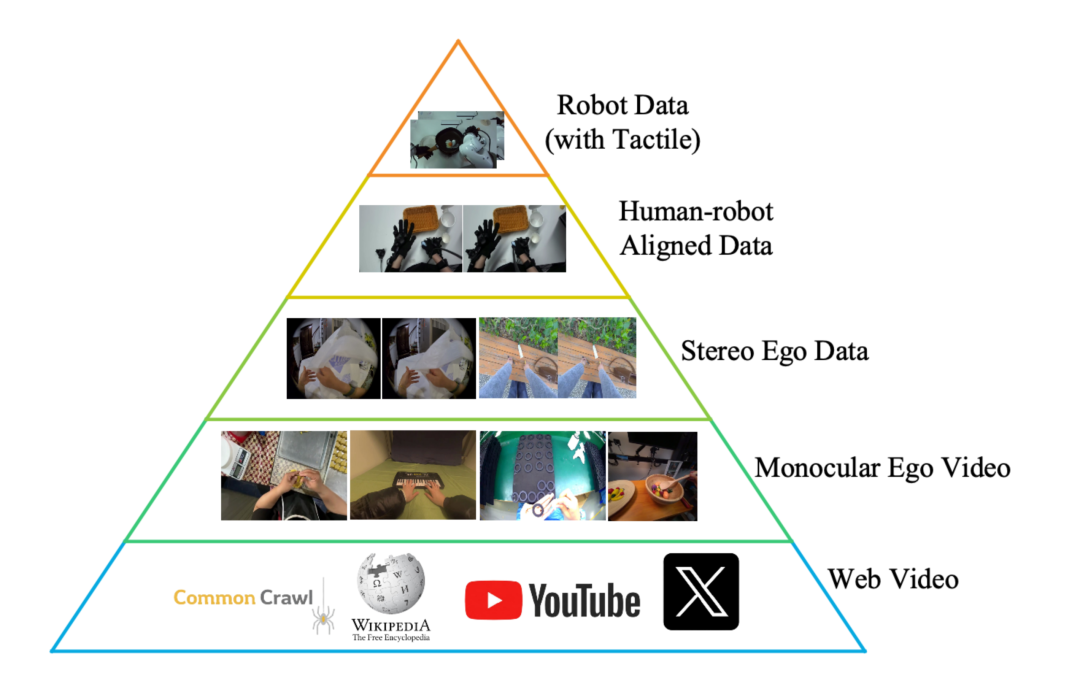
其预训练语料包含约13万小时原始第一视角数据,训练过程并非把这些视频一次性用于动作学习,而是逐级增加空间和行动信息。
第一阶段使用单目第一视角视频,让模型学习物体、场景及人手交互如何随时间变化。第二阶段加入同步双目视频和人手动作,以隐式深度线索和更准确的三维手部姿态,学习手在空间中如何接近、接触并改变物体。
进入机器人领域中间训练后,数据重心再转向超过100小时的机器人轨迹及人机对齐数据,将这些经验适配到机械手的关节和控制空间。从观察人类交互,到学习精细空间操作,再到适应机器人本体,不同层次的数据分别承担不同的学习任务。
人类数据负责扩大模型见过的物理经验,机器人真机数据则完成从“人如何操作”到“机器人如何执行”的最后一段对齐。生数科技的数据方法论,有效拓展了真机数据的利用方式,灵巧手扩展操作经验,由此有了真机采集之外的重要来源,也为缓解采集规模的约束提供了一条切实路径。
这条路径是否有效?论文中有两种验证。
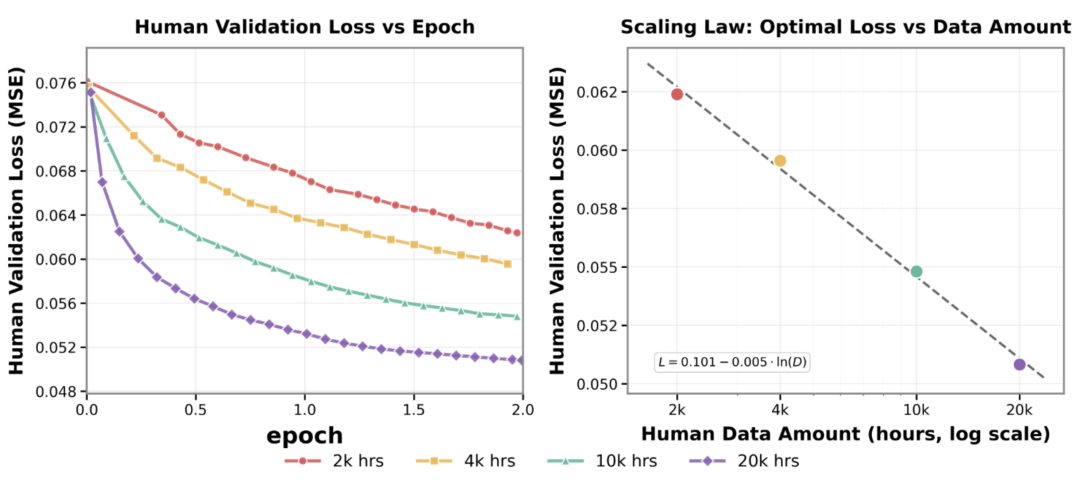
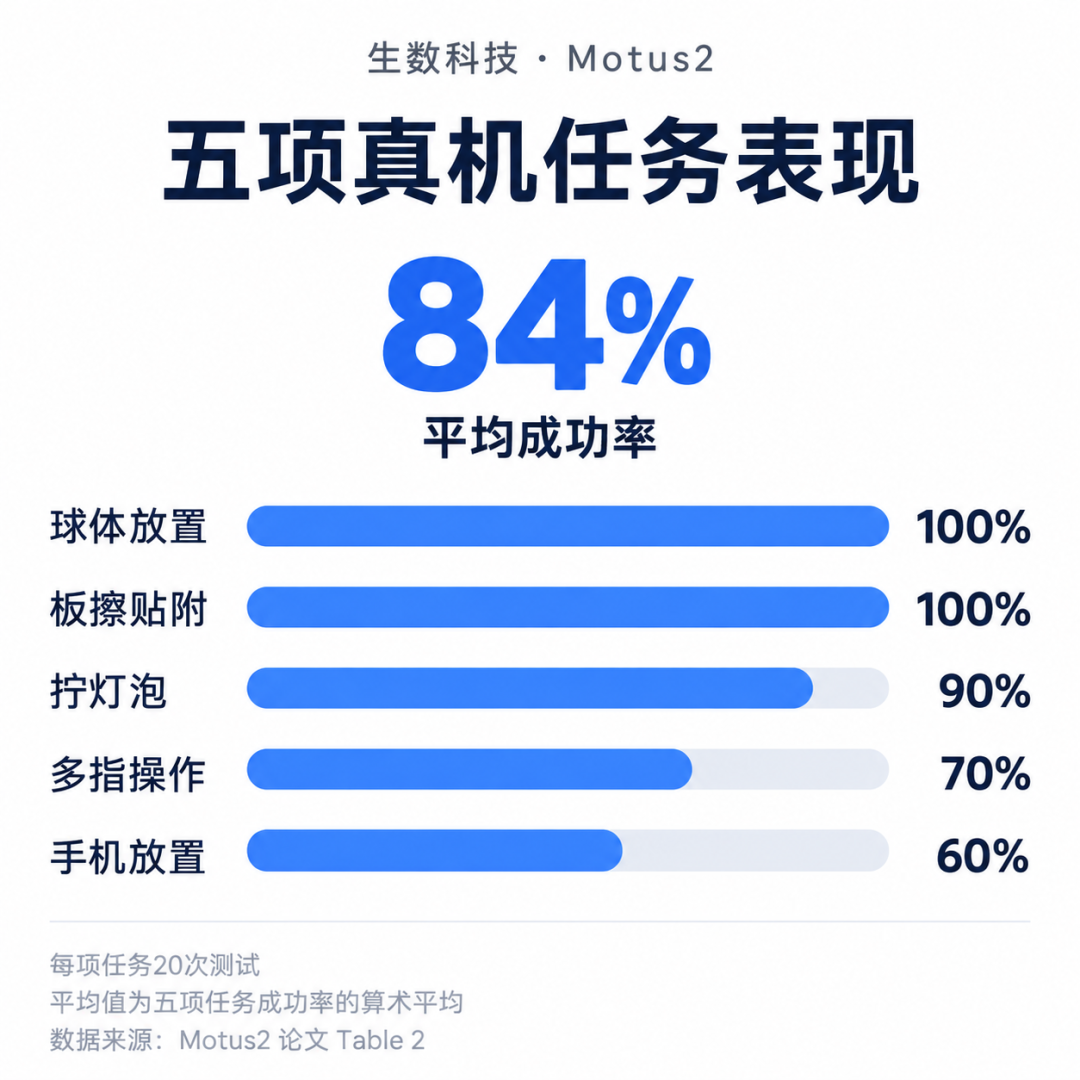
分别使用2千、4千、1万和2万小时双目数据训练模型,在测试范围内,人类动作预测误差随数据规模增加持续下降。另一组真机实验中,在相同目标任务微调条件下,仅经过人类第一视角预训练的版本,五项真机任务平均成功率为51%;加入机器人领域中间训练后,达到84%。两组结果分别验证了经验扩展与本体适配的作用,人类数据提供可持续扩大的操作先验,机器人数据则将先验转化为具体身体的执行能力。
不过,数据规模扩大并不能解决灵巧操作中的全部信息缺口。
第一个缺口来自记忆。在寻找隐藏方块的任务中,方块被放到杯子下面,再打乱杯子位置,仅凭最后一帧画面已经无法判断方块位置,模型必须利用此前的观察才能找到目标。对这类任务而言,历史并不是辅助信息,而是判断当前状态的必要依据。
Motus2比较了两种长时上下文机制。全局自回归保留全部视觉历史及整段任务的时间坐标;混合记忆保留起始画面和近期观察,将中间信息压缩为记忆Token。在寻找隐藏方块和根据历史提示按键两项真机任务中,前者平均成功率为57.5%,后者为25%。
这组结果呈现了长任务部署中的一项取舍,压缩历史可以控制计算开销,但损失是不可逆的,关键观测一旦被压成模糊 token 就找不回来了。这对部署决策有直接含义,在需要长期记忆的任务上,不能为了省计算而牺牲信息完整性。世界模型要走向更长的操作过程,需要同时考虑记忆的效率与有效性。
第二个缺口来自触觉。手指已经接近杯子,不代表接触已经建立;物体已经被握住,也不代表抓取稳定。进入精细操作后,这些接触差异会直接改变动作效果。
生数科技Motus系列模型主要负责人毕弘喆,在接受媒体采访时指出,仿生、高自由度灵巧手是人类第一视角数据迁移的重要落点,而手部遮挡与精细操作需求,也使灵巧手比夹爪更依赖触觉。
从传感器性能、接触识别到触觉数据集,行业已经围绕机器人怎样获得触觉进行了大量探索。但获得触觉信息,与让世界模型及时利用这些信息调整动作,仍有具体的整合难题:接触与受力状态持续变化,信号如何进入模型,又怎样及时影响即将执行的动作?
Motus2采用了分工式的处理方式。先由主模型把完整动作块去噪到中间状态,并缓存已有的视觉和动作特征,再将其拆成更短的动作子块。每个子块执行前,轻量触觉专家读取最新的力觉和形变信息,完成最后一次动作去噪和修正;训练时,它还会预测动作后的力信号,学习接触状态如何随行动变化。
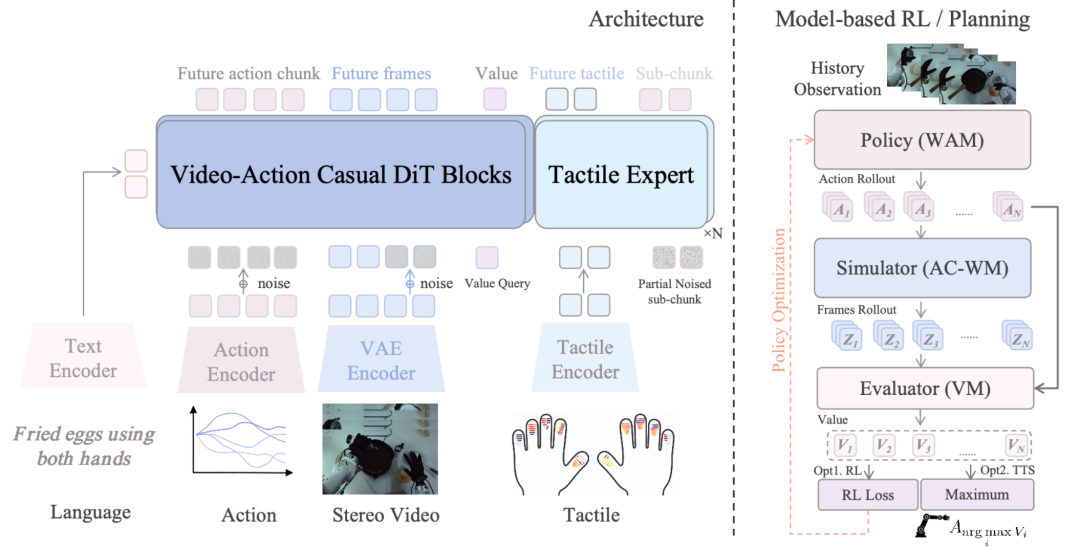
与将触觉作为独立感知模块、再交给下游控制系统处理的方式相比,Motus2只需要触觉专家复用主模型特征并参与动作细化,不必为每次触觉更新重新运行完整骨干。在抽取纸杯和双手撕纸两项任务中,加入触觉后,平均成功率由60%提高到72.5%。
这样的设计打通了触觉的价值从补充感知到动作生成的技术墙,为一直以来业内针对触觉相对割裂的认知提供了一条直接且顺畅的解法。在许多人还在谈论触觉如何参与、怎样参与的时刻,Motus2直接摆出了触觉与大型世界模型协同控制的实现方式。
从经验迁移到现场控制,Motus2的全模态体系回应了能力复用的不同条件,既从更广泛的数据中学习操作规律,也在执行时保留历史线索、获取最新接触信息,让已有经验能够结合当前状态发挥作用。空间、记忆和触觉共同构成更完整的物理状态,世界模型预演出的可能性才可能更接近机器人真正面对的世界。
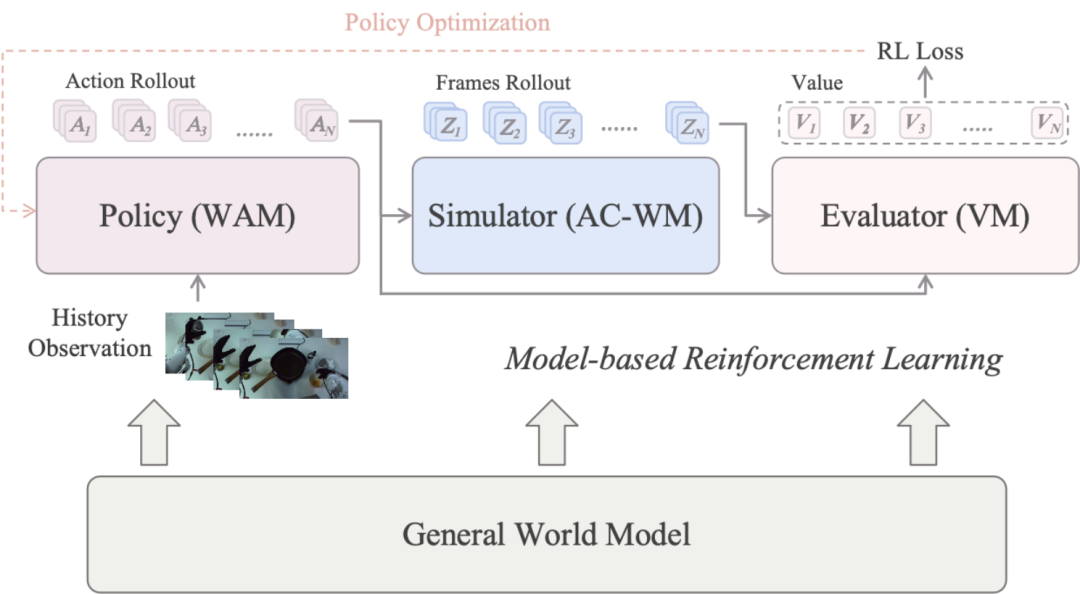
如果说数据Scaling为世界模型建立了物理地基,那么Motus2在模型Scaling上的核心变化,也是它真正补上鸿沟的地方,是把策略、模拟器和评估器接进同一条因果链。
当然,这三者并不是分别训练、彼此拼接的三套系统,而是同一个共享参数视频—动作模型提供的三种控制接口:策略根据指令、机器人状态和视觉历史提出候选动作;模拟器预测各个动作的视觉后果;评估器判断这些后果推动了多少任务进展。
为保证这个顺序,Motus2从机器人领域中间训练开始使用Action-first Mask,即“动作优先”的注意力可见性设计。动作Token只能读取执行前的上下文,不能看到对应的未来画面和价值;未来视频可以读取动作,价值查询则可以同时读取动作与未来,但不会将结果泄露回动作生成。
这相当于把“动作改变世界、结果接受评价”的因果顺序写进模型的信息流,让联合训练遵循了部署时的信息条件。否则,动作生成在训练中可以利用执行后才会出现的画面,真实控制时却没有这份“答案”。
动作生成与未来预测的统一已成为具身世界模型的一种探索方向,但预测、行动、反馈等几大方面的有机整合与有效链路,却鲜有人真正搭建成功。生数科技则以统一设计和强因果约束,把预测与行动从共同训练推进到共同决策,还真正回答了“预测之后怎么办”:让模型对不同未来的理解,转化为机器人选择和改进行动的依据。
这样的设计也让模型能够按需调用能力:普通控制时,机器人可以只调用策略接口,直接生成动作;只有进行规划和策略优化时,模型才继续生成未来并读取价值,避免每一个控制步骤都承担完整视频推演的计算成本。
在这套统一架构下,不同质量的轨迹也被分配给不同的学习目标。经过筛选的成功示范监督动作学习;失败、次优及与任务无关的轨迹不被策略直接模仿,但仍用于学习动作后果和任务进展。
这并不是简单地给成功打高分、给失败打低分。一次最终失败的执行,前半段仍可能完成了正确的接近和对准,偏差可能直到后续接触过程中才出现。模型需要识别的是这种局部进展,而不只是视频最后的成败。
一次失败的割芦苇实验中,机器人完成接近和对准时,评估值升至0.27;当芦苇没有被切断、反而被提起后,数值在两秒内降至−0.39。这表明失败轨迹并非从头到尾都被判为低价值,模型能够区分执行中的推进与偏离,为比较动作提供比最终成败更细的依据。
业内以动作模仿为目标的数据筛选,往往只关心哪些动作值得做,但却忽略了一连串动作内的局部进展与因果价值,失败动作也能帮助模型认识行动后果。生数科技则秉持“哪些交互值得模型从中学习”的实用主义,根据不同学习目标分配数据用途,拓宽了昂贵的采集数据的使用范围。
评价结果随后通过两条路径进入行动。
第一条路径发生在推理阶段。Best-of-N规划让策略一次生成多组候选动作,模拟器分别预演后果,评估器再对不同分支排序,机器人执行价值最高的一组。执行一段动作后,系统获取真实观察,从新状态重新规划,以滚动方式限制预测误差的累积。
第二条路径发生在训练阶段。Motus2使用DiffusionNFT,将候选分支的价值评分转化为策略优化信号,只更新动作相关参数,模拟器和评估器保持固定,使高价值动作更容易被生成,低价值动作则受到抑制,评估结果由此改变策略的动作分布。
规划负责改善的是当次选择,模型强化学习改变的是后续候选动作的生成倾向。这样的安排是生数科技为世界模型的预测投入转化为持续的行动收益,提供的另一条路径。
在放置手机和多指操作两项真机任务中,基础版本的平均成功率为65%;单独加入规划后提高到67.5%;加入基于模型的强化学习后达到72.5%;两者结合后达到75%。相比单纯增加推理阶段的候选选择,把评价结果进一步反馈给策略,带来了更明显的提升。
Motus2所谓“自进化”的技术含义也由此明确,模型自己预测出的未来,不再只是简单地展示结果,而是开始成为选择动作和更新策略的反馈来源。它并非已经能够在开放环境中无限自主学习,而是在任务化的后训练流程中,建立了一条可以运行和验证的“生成动作—预测后果—评价结果—改进策略”闭环。
把 Motus2 放回生数科技的技术版图,能看到一条非常清晰的选择线 ,不是每次发一个新模型加几个模块,而是对 “世界模型到底应该是什么” 这件事,从头到尾有一套一以贯之的判断。
今年中关村论坛上,生数科技提出以基座世界模型为核心,统一感知、理解、预测与行动。Motus将动作与未来预测放在同一个模型中,Motus2则继续处理一个问题:这些能力统一之后,如何相互促进,而不是仅仅并排存在?
这种递进体现出了生数科技的技术直觉:把行动视为世界模型连接物理世界的因果接口。动作会改变环境,带来新的视觉、触觉和任务结果;这些结果又进入下一轮预测、评价和学习。因此,判断具身智能世界模型的能力,不只要看它能否生成逼真的未来,也要看它能否根据动作推演后果,并利用这种联系组织预测、评价与策略更新,最终改善具体行动。
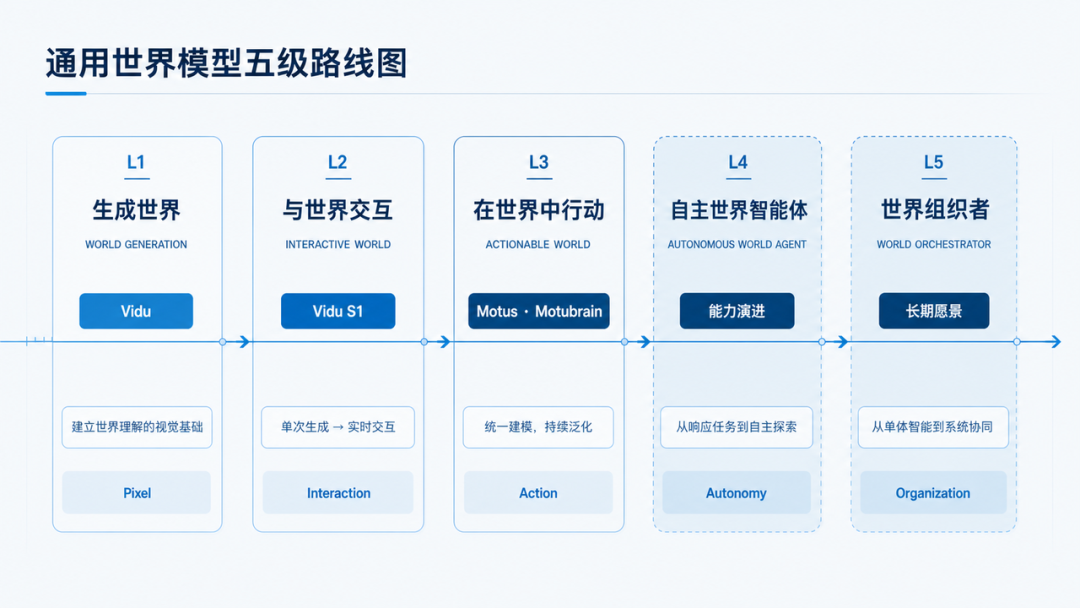
这也可以放入生数科技提出的通用世界模型五级路线中理解。从生成、交互,到在世界中行动,再到自主世界智能体,模型与外部世界的联系逐步加深。Motus2在任务化真机实验中形成的“行动—预测—评价—改进”链条,可以被视为从L3“在世界中行动”向L4“自主世界智能体”推进的一次技术尝试。评估器、工作记忆和策略反馈,则为模型进一步走向持续学习提供了基础接口。
在行业普遍用 “任务覆盖了多少种”“ 单项成功率涨了几个点 ” 来展示进步的时候,生数科技的路线选了一条更难但更本质的路,不追求一次性证明模型 “会做”,而是回答模型 “为什么会做、能不能自己做得更好”。扩大任务种类当然是能力展示,但如果模型换个场景就重新从零学起,任务数量再多也只是数据堆叠。生数关注的是能力增长的机制 。有没有一个反馈回路让模型越用越好。这是从 “展示能力” 到 “建设能力增长系统” 的区别。
但模型内部形成闭环,并不意味着世界模型已经能脱离外部基础设施独自进化。
闭环自进化有一个隐含前提:评估器的打分必须可信。如果评估器本身判断失误,模型就会朝着错误的方向改进,越练越偏。而评估器靠什么校准?靠真实世界的 ground truth。机器人数据怎么定义和筛选、模型能力怎么稳定评测、仿真结果怎么和真机表现对齐,这些外部基础设施决定了闭环能不能持续转下去。
生数与光轮智能的合作,围绕这些环节展开。双方今年6月宣布共建世界模型数据标准、可复现评测体系,并探索真实场景验证与反馈迭代。其中,基于光轮智能RoboFinals平台的评测合作,计划将能力诊断与数据补充、模型优化衔接起来。这些行动共同指向一个现实:世界模型走向真实行动,既需要模型闭环,也需要数据、评测和场景反馈组成的外部闭环。
今年4月,生数科技完成近20亿元B轮融资。资本投入本身不是技术领先的证明,但对于一条同时依赖大规模数据、基础模型训练、机器人硬件和反复真机验证的路线,它意味着更长的投入周期和更完整的资源配置。
所以 Motus2 真正值得看的,不是它在某个灵巧操作任务上达到了百分之多少的成功率,而是生数把两件事同时做实了:模型内部,因果闭环已经跑通,动作、预测、评价、改进在同一套权重里闭合;模型外部,数据、评测和场景反馈的基础设施正在搭建 ,闭环不是自说自话,而是和真实世界持续校准。
世界模型的竞争到了这一步,比的不再是谁生成的未来画面更逼真,而是谁的闭环转得更真,模型能不能在真实世界中,根据自己行动的结果,持续变得更好。
结语
Motus2 的意义,可以用一句话收束:
世界模型的终点不是预测更多可能性,而是在可能性中找到那条最确定的行动路径,并靠自己越走越准、越走越远。
从13万小时人类数据建立的物理地基,到策略-模拟器-评估器三位一体的收敛闭环,再到生数对“动作是因果接口”的技术直觉和“人类经验迁移”的数据Scaling路径,Motus2展示了一条从“会预测的世界模型”走向“能自我改进的具身智能体”的可行路径。
特别声明:本文为合作媒体授权DoNews专栏转载,文章版权归原作者及原出处所有。文章系作者个人观点,不代表DoNews专栏的立场,转载请联系原作者及原出处获取授权。(有任何疑问都请联系idonews@donews.com)


