


9月22日消息,据雷锋网报道,这几天,全网都被 Jev 刷屏。推特上诸多大佬用它打马里奥,过滤垃圾信息,炒币,称它为“Agent 时代的系统 1”;也有人说这就是一个 JSON 分类器。
Jev 是什么?Jev 是 ChatGPT 早期核心贡献者之一 、RLHF 之父 Diogo Almeida 创立 TypeSafe AI 后,闭关两年的开山之作。它与以往的模型很不同的点是,它不生成文本。
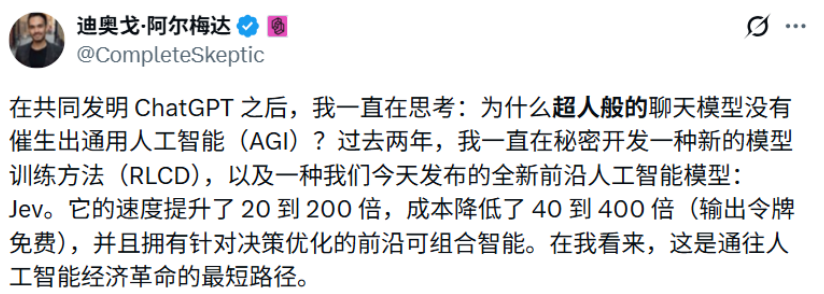
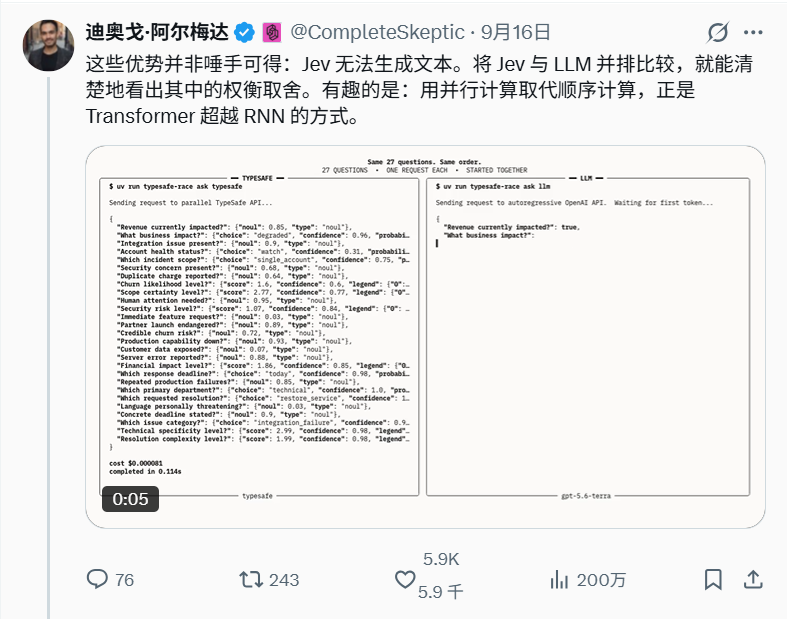
它接收非结构化输入或问题,返回带类型的概率决策,代码可直接依据结果执行动作。简单理解,这是一个“自动判断器”,你给它输入一些内容,它还你一个“决策结果”。它只做三件事,bool、choice、score,bool 是 yes 或者 no 判断,choice 是做选择,score 是打分。
所以,Jev 最大的特点就是“极速”与“极省”。官网介绍,它比普通 LLM 快 20-200 倍,成本低近两个数量级,输出 Token 免费。这种快,来自于新的模型架构、并行采样器以及一种全新训练方法“校准决策强化学习(RLCD)”。
其中,最值得注意的,他现在选择 RLCD,是出于对他当年创造的 RLHF 的反思。当年, GPT-3 还只会文字接龙,RLHF 就是基于人类的反馈诞生的强化学习,它让 AI 的表达与人类偏好对齐,从而催生了 ChatGPT。
但随着 RLHF 被大规模使用,人们发现大模型开始为了讨好人类瞎回答,尤其是面对那些人类都无法理解、无法打分的复杂问题时,RLHF 会“不懂装懂”。
于是,可验证奖励的强化学习(RLVR)诞生了,它基于客观的编译器或数学验算程序的反馈,对就是对,错就是错,直接开启了 OpenAI o1/o3、DeepSeek-R1 为代表的“大模型深度推理时代”。但为了追求“正确”,模型的深度思考,让生成答案变得非常慢、极其消耗算力。但在海量的企业自动化业务中,“毫秒级响应且高准确度”才是真实痛点。
于是,RLCD 诞生了。Diogo Almeida 认为让大模型盲目堆规模和长篇大论打草稿,并不适合高频的工业级决策。RLCD 要做的,就是逼机器输出“认知内的概率答案”,有几成把握说几成把握,绝不瞎编。
所以,Diogo Almeida 表示,在这种训练模式下,Jev不会有幻觉。RLCD 不再是传统 LLM 一个字一个字往外蹦生成模式,通过“并行采样”,在机器内部同时看一堆选项,并在 70ms-500ms 内输出结构化的最终决策。同时,在 System One 这类封闭决策任务上,它可以取得和 GPT-5.6 Terra 相当的表现。


