


10月8日消息,北京时间 10 月 7 日,Perplexity 正式开源发布 pplx-embed-v2-late—— 一对采用 ColBERT 架构(晚交互)的多模态嵌入模型,分为0.6B 和 9B两个版本。
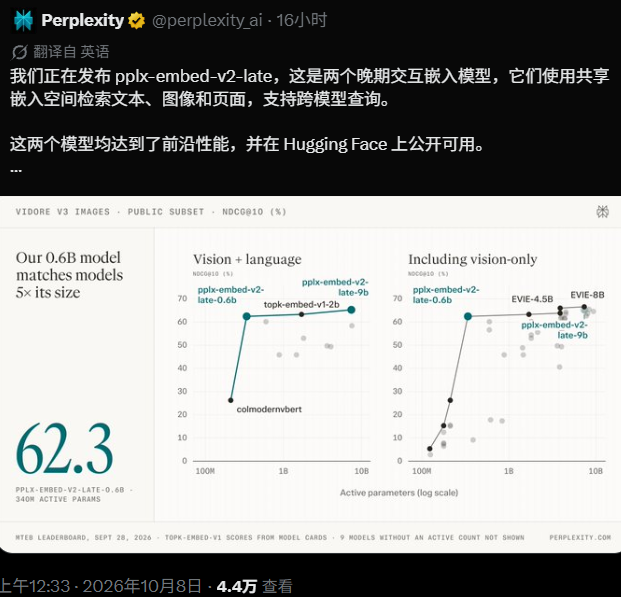
模型可同时检索文本、图像及渲染后的 PDF 页面,且两者共享同一个嵌入空间,权重以 MIT 许可证在 Hugging Face 上开放,允许商用自托管。
定位:为检索而生
与聊天式大模型不同,嵌入模型负责把内容映射为可检索的向量。pplx-embed-v2-late 的特别之处在于它突破了传统稠密模型 "单向量瓶颈",为每个 token 保留一个 128 维向量,检索时用 MaxSim 打分(每个查询 token 找到最优的文档 token,再累加这些最大值)。
由于页面被当作图像编码,无需 OCR 即可检索 PDF、幻灯片和扫描件。
模型基于 Qwen3.5 与双向注意力训练,两者均由内部 18B ColBERT 教师模型通过 token 级 LEAF 风格蒸馏而来 —— 这正是二者共享嵌入空间的来源。
小模型查大模型索引
由于 0.6B 与 9B 共享嵌入空间,开发者可用 9B 在云端离线构建文档索引,再用 0.6B 在设备端实时查询,从而大幅降低查询成本。
测试中,用 9B 建索引、0.6B 查询在 ViDoRe v3 图像检索上得分 63.5%,高于 0.6B 两端全用时的 62.3%,而查询成本不变。
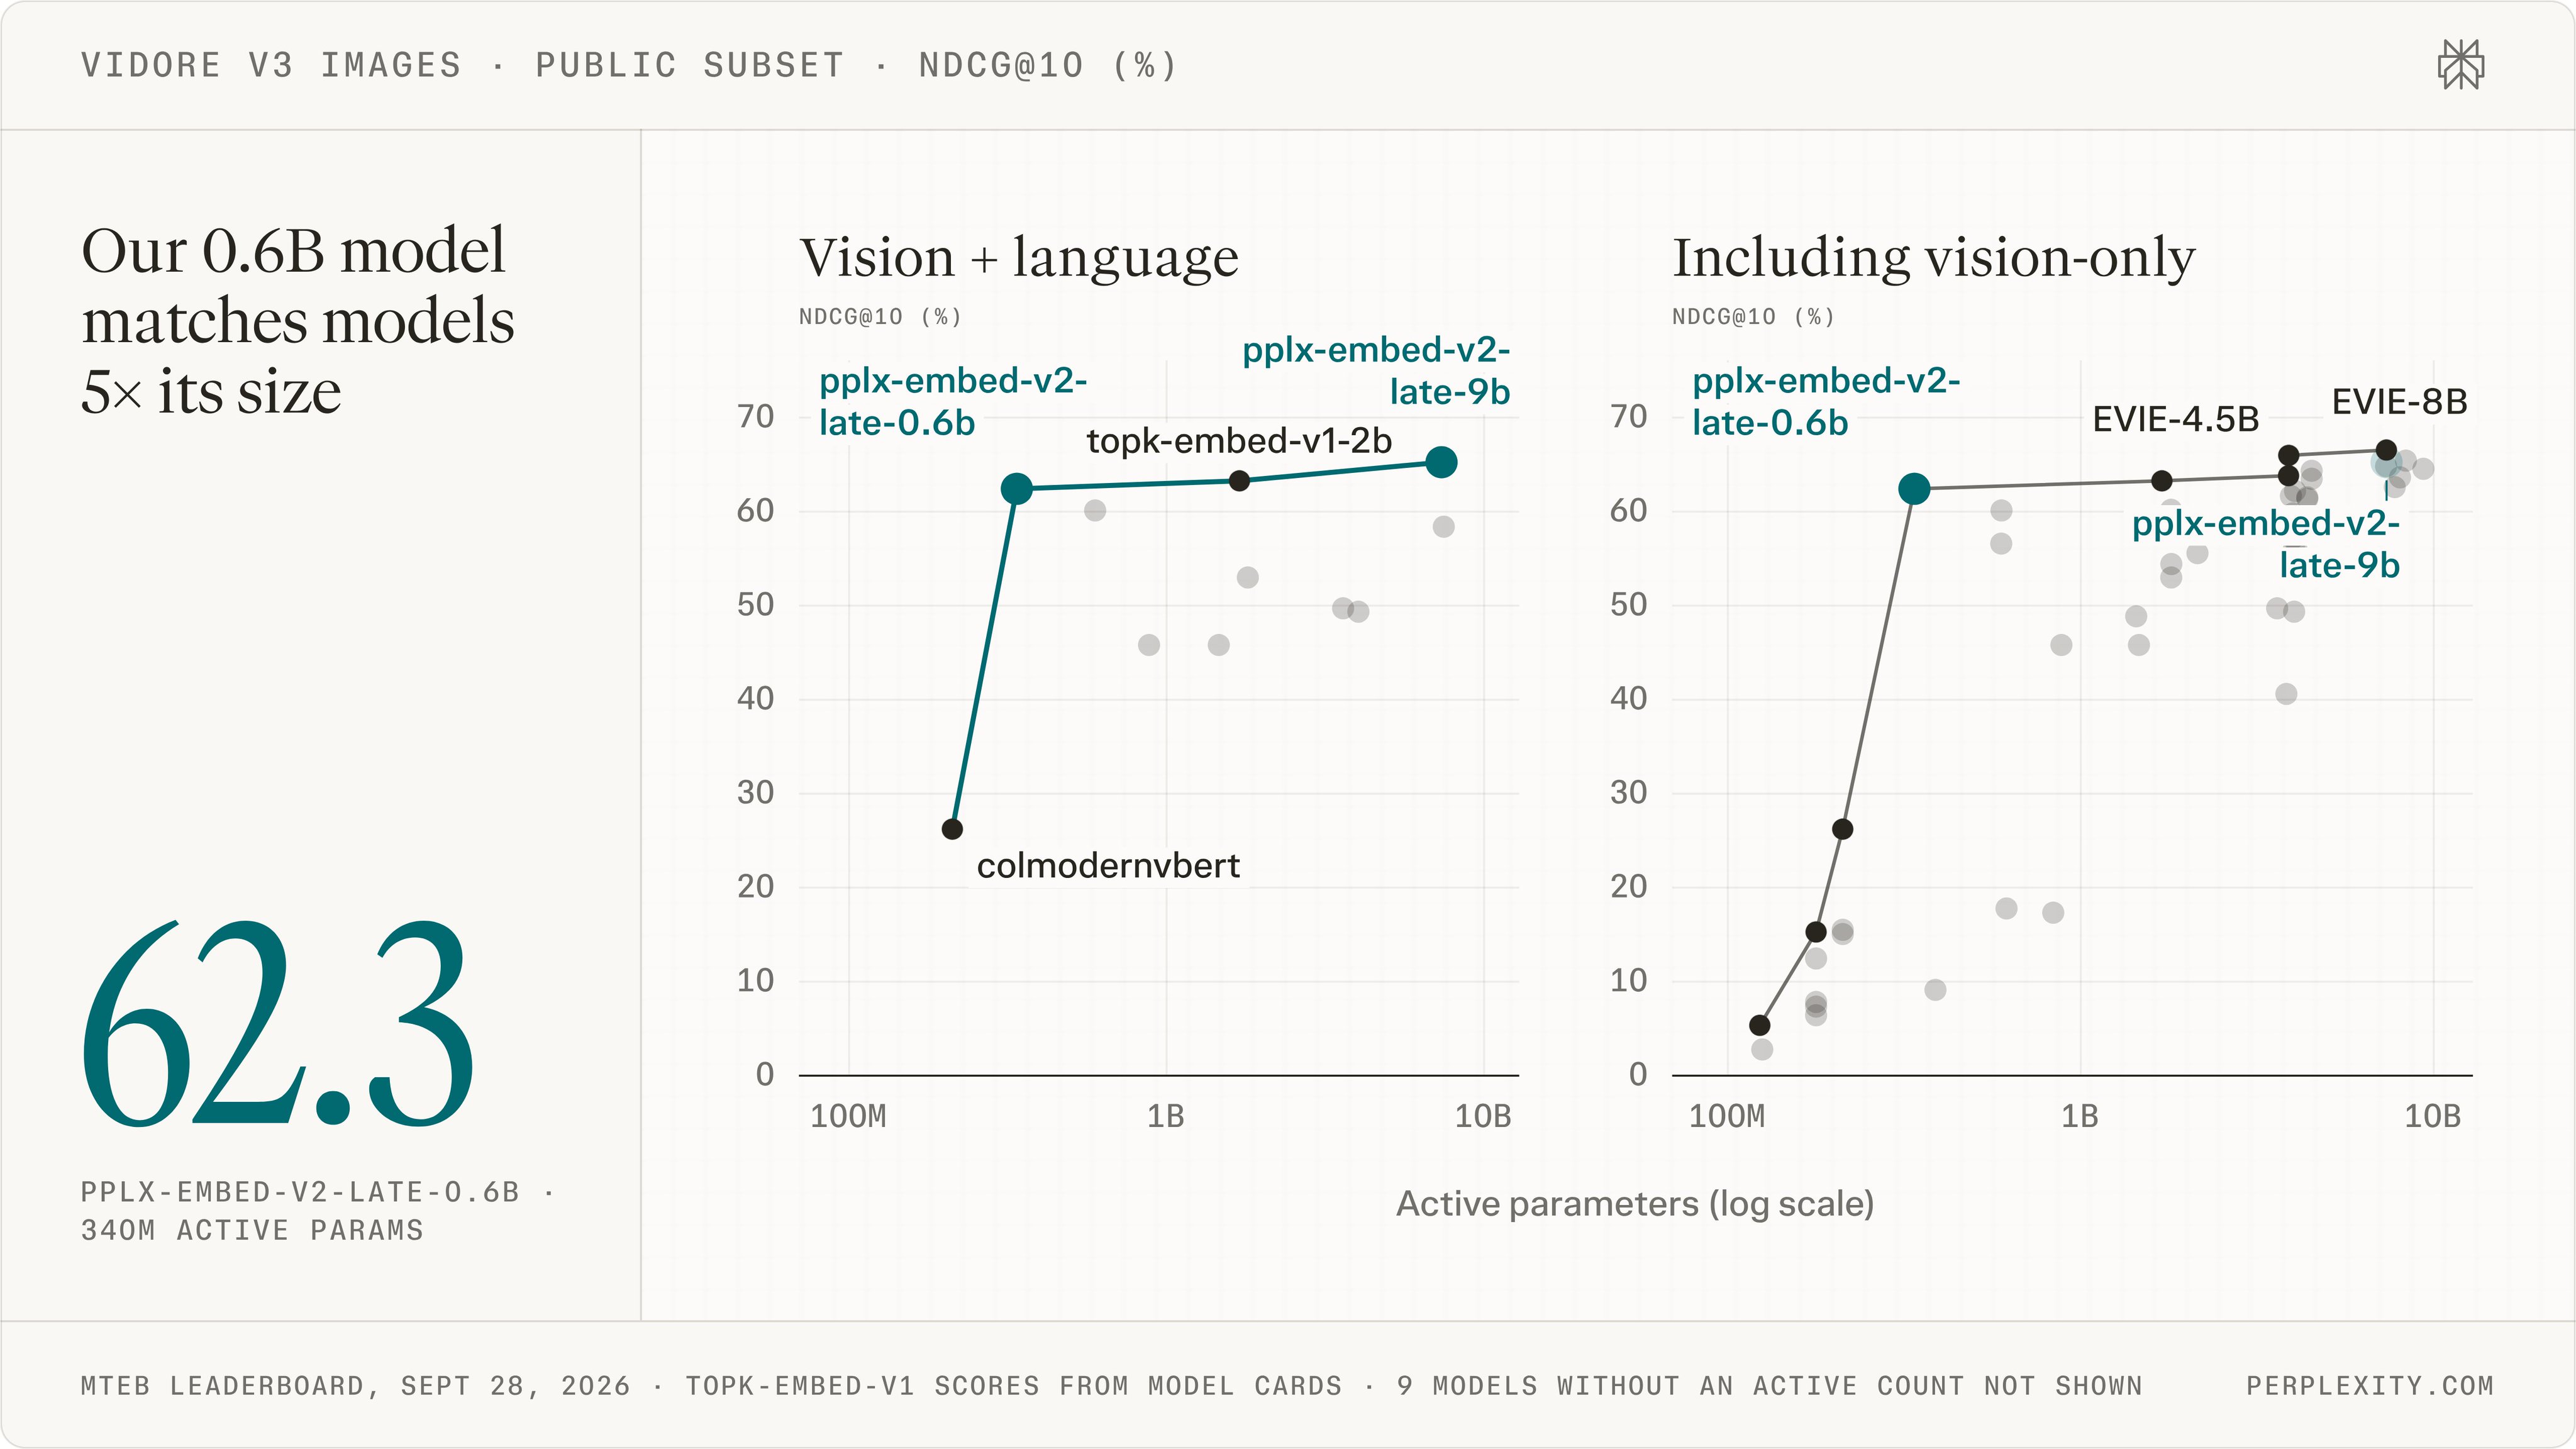
Perplexity 表示,0.6B 模型在 ViDoRe V3 上可匹敌约 5 倍活跃参数量的同类模型。
目前该模型仅支持自托管,Perplexity API 托管端点已规划但尚未上线。


