


10月8日消息,2026 年 10 月 8 日,Liquid AI 发布开源模型系列 Open d1,主打 "零输出 token" 的实时决策能力。模型读取输入后不生成任何文字,而是通过一次前向传播直接返回校准过、带类型的概率答案,单个问题延迟低至 8 毫秒。
本次开源了两个权重模型:
- d1-3B(3.12B 参数):可读取文本与图像;
- d1-omni-600M(587M 参数):可读取文本配图像、或文本配音频,属早期研究版本,未公布延迟数据。
两者均为决策模型,而非聊天模型:接收一个状态加一组命名问题,读取一遍后为每个允许的答案返回一个概率,输出 token 数为 0。多个问题可在一次调用中共享同一个状态。官方推荐用途包括路由、审核、意图分类、重排序、LLM-as-a-judge 打分、智能体护栏和视觉检查。
目标场景明确指向英伟达栈上的实时决策,覆盖 DGX 服务器、RTX 工作站和 Jetson 边缘板。
- d1-3B 起点是 LFM2.5-VL-3B(仅解码器的视觉语言模型)。Liquid AI 将 LFM2.5-2.6B 与该模型文本主干权重做平均,再用不同随机种子和数据配比微调出多个检查点后合并。
视觉侧采用 400M 的 SigLIP2 NaFlex 编码器,上下文长度为 32768 token。官方指出,长输入、打乱答案选项、修复数据捷径,比使用更高级的技术更重要。
- d1-omni-600M 起点是 LFM2.5-Encoder-350M(双向编码器),结构上包含 381M 的共享主干与决策头、94M 视觉编码器、112M 音频编码器。
音频编码器为 17 层 FastConformer,上下文 16384 token,音频片段上限 30 秒。一次请求只能携带图像或音频之一,不能同时携带;音频训练仅覆盖英语说话人对助手请求的场景。
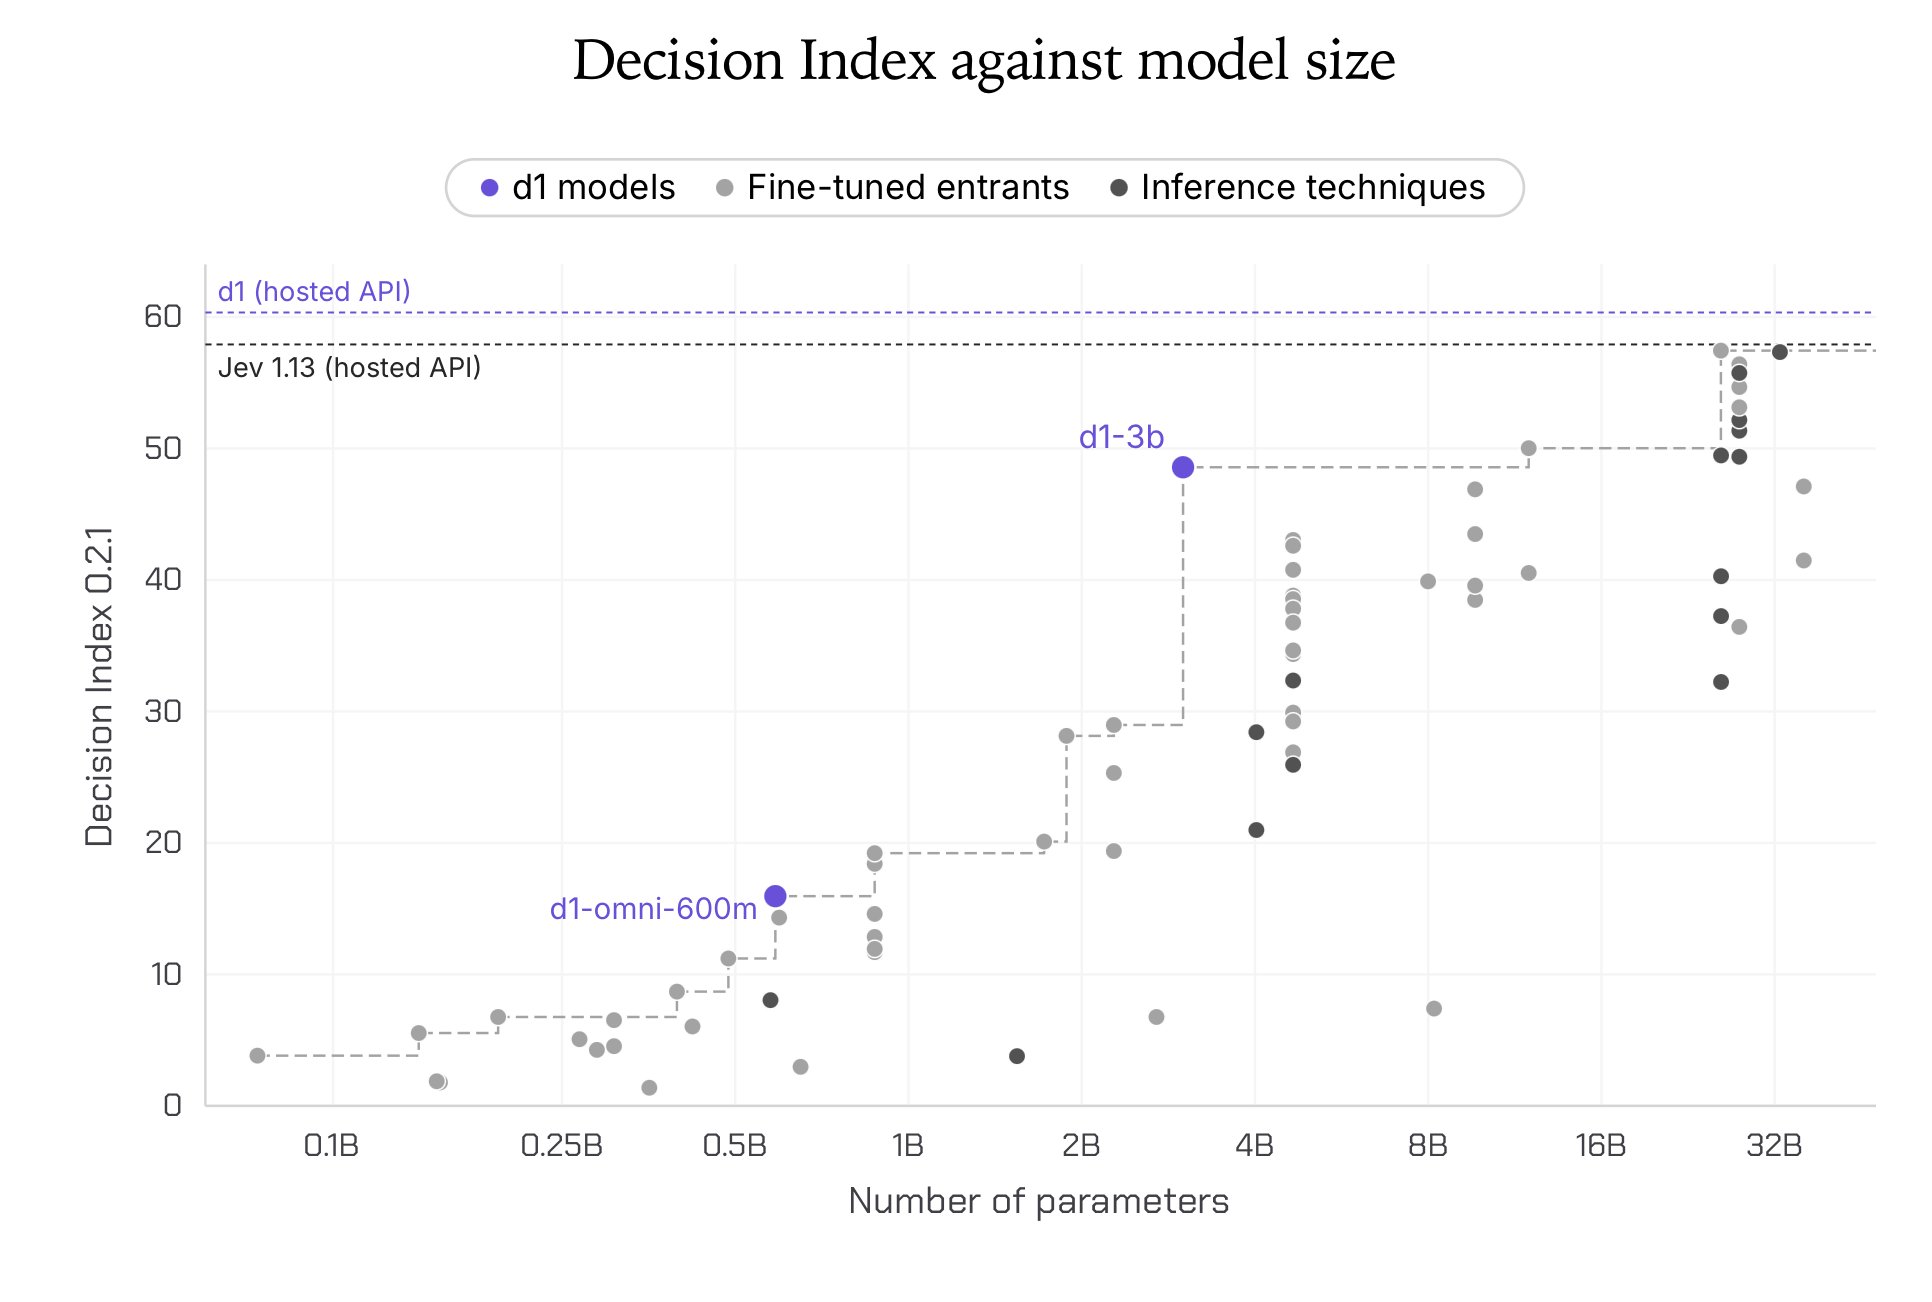
- 在 Decision Index v0.2.1 上,d1-3B 得 48.57,超过所有 10B 以下模型,略高于 Decider 35B-A3B 的 47.11;仅 Winnow-12B 的 50.02 更高。该分数由 Liquid AI 自行用官方评分器得出,并非榜单提交。d1-3B 在 Tools(74.5)与 Arts(36.3)两类领先,Knowledge(23.8)相对落后。
- 七个公开文本基准上,d1-3B 平均 82.9,高于 Decider 4B 的 81.1;d1-omni-600M 平均 78.4,在 Civil Comments(95.8)与 PAWS-X(79.5)上拿到最高分。11 个图像基准上,d1-3B 平均 74.1,其基座模型为 73.9。
两个检查点已上架 Hugging Face,可通过 Transformers 加载,llama.cpp 首日即支持;许可证为 LFM Open License v1.0,年收入低于 1000 万美元的商业使用免费。


