





10月30日消息,金融 AI 研究企业 Samaya AI 近日发布专项后训练金融智能代理模型 Samaya Sterling。基于英伟达 Nemotron 3.5 Lightning(30B MoE,实际激活仅 3B 参数)底座,经过四阶段后训练改造,该模型在金融投资研究基准数据集 FrontierFinance 上得分超越通用旗舰大模型 Claude Fable 5.1,单条任务成本仅为后者的 1/11,为金融 Agent “小模型打大模型” 提供全新工程路径。
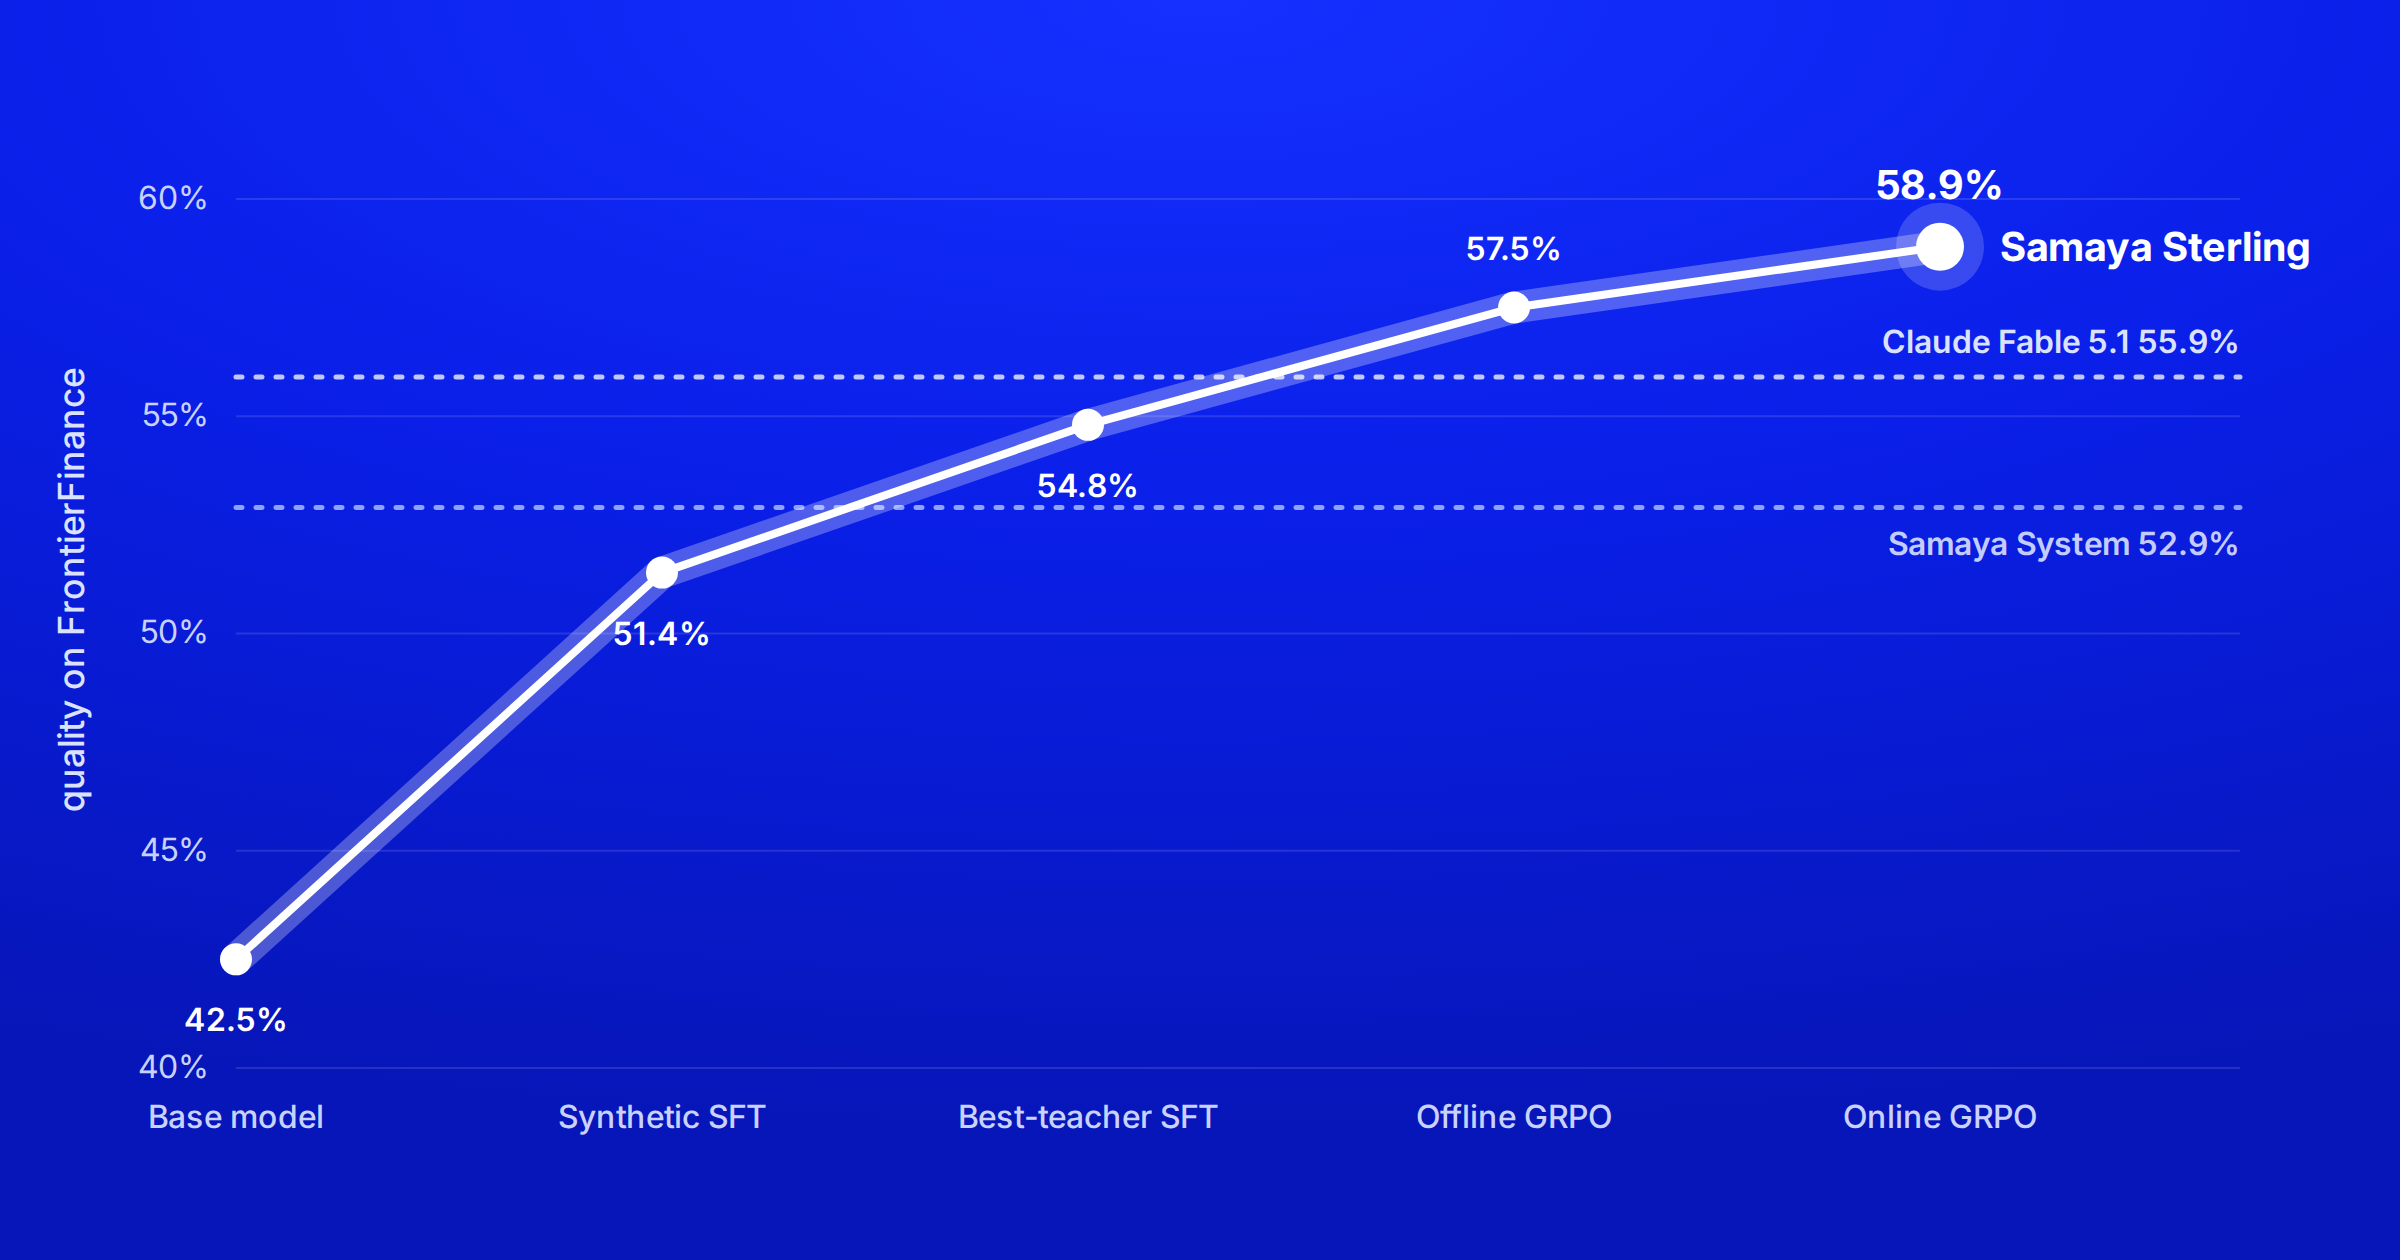
在 Samaya 打造的FrontierFinance评测基准中,集合 220 道专业金融研究问题,覆盖标的筛选、宏观研究、财报分析等真实投资全流程工作流。此前通用顶尖模型 Claude Fable 5.1 仅取得 55.9% 的达标率,单题运行成本高达 6.89 美元。
经过完整后训练流程,Samaya Sterling 达到58.9%的 rubric 达标率,高出 Claude Fable 5.1 三个百分点,单题成本仅0.61 美元,二者延迟表现接近(282 秒 vs 268 秒);开启高算力深度调研模式后,模型性能进一步提升至 60.6%,成本上涨至 1.83 美元每道问题。
Samaya Sterling 采用两阶段监督微调 SFT + 两阶段 GRPO 强化学习 RL的完整四阶段训练范式,全程搭配自研金融 Agent 运行框架(harness)联合优化,模型与工具环境协同迭代,而非单纯微调模型权重。
为适配仅 3B 激活参数的小底座,Samaya 对 Agent 运行框架做深度改造:裁剪系统提示词、合并工具接口,增设压缩器、精简器两个辅助模型,对工具返回的长结果、多轮调研轨迹做摘要压缩,让小模型也能支撑多轮复杂工具调用。
训练前,基础 Nemotron 模型单题平均仅调用 3 次工具;训练完成后,中位数工具调用上涨至 17 次,调研深度显著提升。评测显示,模型增益不局限简单题目,在最难三分之一的测试样本上,指标提升幅度甚至高于整体平均水平。
项目团队还验证了质量‑成本的可控权衡:在强化学习奖励函数增加上下文惩罚项,可降低 30% 成本,仅损失 1.1 个百分点精度;反之增加上下文奖励,可小幅抬升效果,但成本翻倍。这意味着开发者不需要硬编码限制条件,仅通过奖励塑造就可以动态调节 Agent 的成本与性能平衡点。
Samaya 团队表示,后续有三大方向:探索多智能体集群、面向机构定制专属金融模型,同时将这套训练配方迁移到更大基座模型,早期实验已经看到进一步性能提升。
该研究证明:面向垂直专业领域,不需要一味追求超大通用基座,通过 “底座模型 + Agent 框架协同后训练”,中小参数模型也可以实现超越前沿通用大模型的效果,同时大幅降低推理开销,对资管、券商等机构落地金融 AI 具备很高参考价值。


