





10月30日消息,语音 AI 公司 Cartesia Research 于 10 月 28 日发布技术博客,详解升级版Hierarchical Networks(H‑Nets,分层网络)架构。该架构摒弃传统 LLM 依赖的人工设计 BPE 分词器,实现端到端从原始字节直接学习,在语言、代码、DNA、图像多模态场景验证显著效率提升。
当前主流大模型普遍采用 BPE 字节对编码做离线分词,属于人工预定义处理流程,模型无法自主学习切分逻辑,在代码、小语种、生物序列等场景存在先天缺陷。
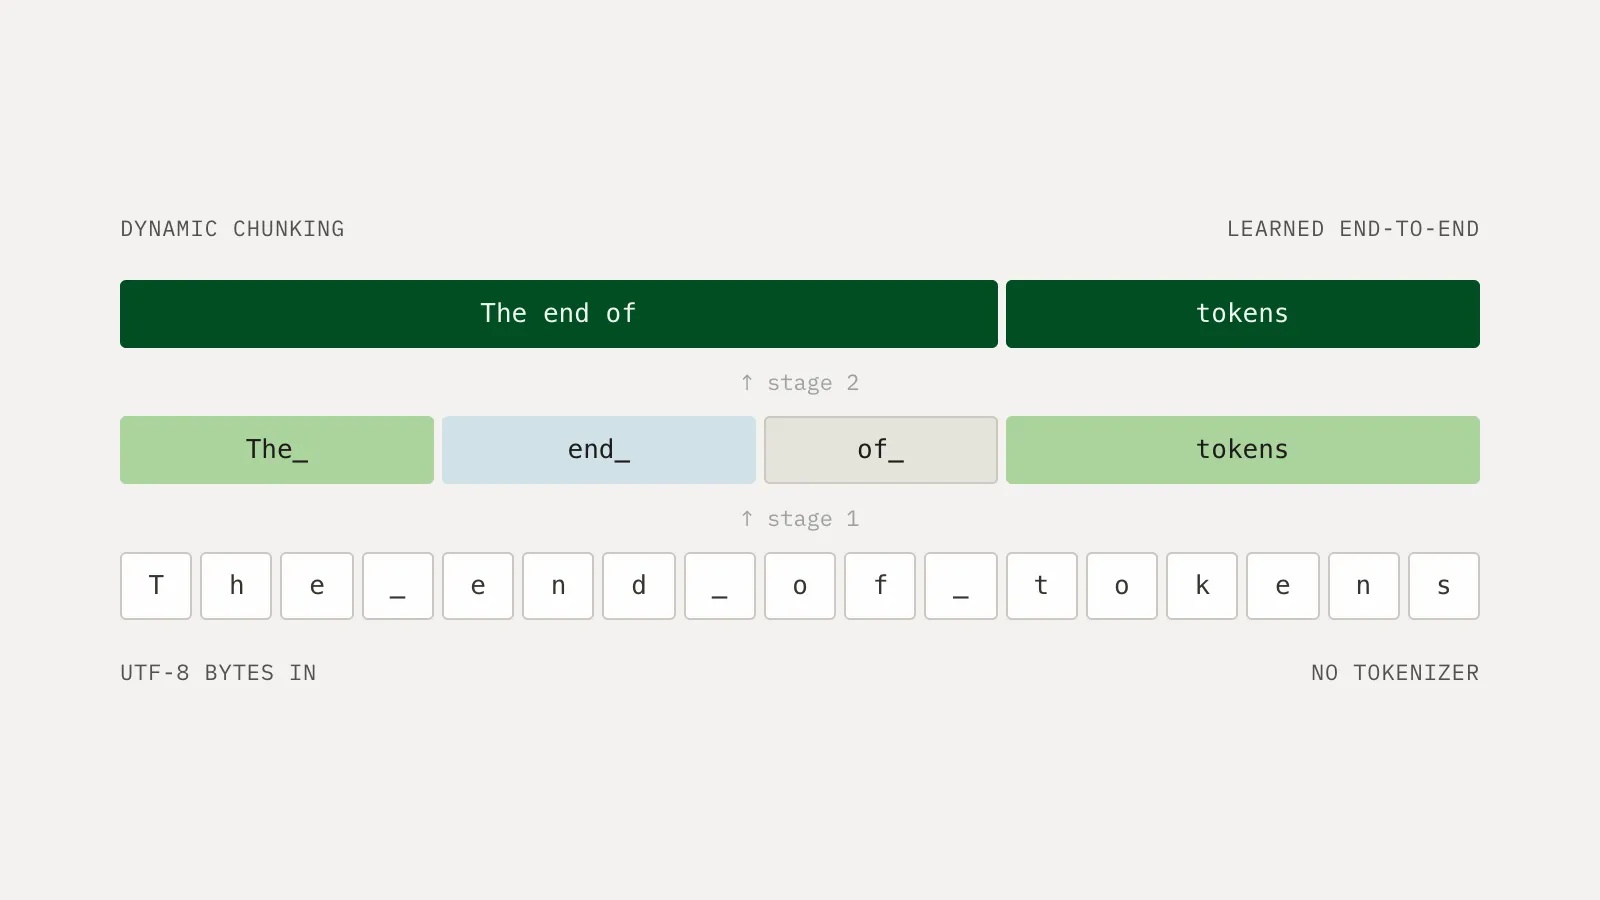
H‑Nets 核心思路是动态分块(dynamic chunking):不再使用固定 token 词典,由网络本身递归把底层原始数据(字节、像素、核苷酸)压缩为高层语义块,编码器完成分块压缩,主干网络在高层块上运算,解码器还原回原始输入,整套流程端到端联合训练,分块边界随上下文动态变化,推理阶段还会出现上下文内分词(in‑context tokenization)的涌现行为:遇到新词会切细,重复出现后自动合并为单一语义块。
在严格控制参数量、FLOPs 算力条件下,1‑stage H‑Net 相比 BPE 基准 Transformer,域内预训练算力效率提升1.28 倍;下游综合评测提升约 2 倍。代码领域增益尤为突出:训练集内编程语言算力效率中位数提升 2.04 倍;从未见过的域外编程语言最高可达5.37 倍,对少见编程语言、自定义 DSL 具备更强泛化能力。
构建 2‑stage 双层分层网络,与开源 SmolLM3‑3B 做对照实验。H‑Net 总参数量 3.67B,与基准算力基本对齐;仅消耗1T 训练 token,就达到 SmolLM3‑3B 使用 11.1T token 才取得的下游评测分数,数据与算力效率实现约 10 倍提升。H‑Net 可根据语义自适应压缩,代码类数据压缩程度显著高于 BPE,减少不必要计算开销。
定性分析显示 H‑Nets 可以自主学习符合语义的切分边界:对中英文、代码都能识别短语、语法单元;代码场景可跨换行、空格做语义分块;推理过程中,反复出现的变量名、模板格式会自动合并为大块,是传统静态 BPE 分词不具备的能力。
H‑Nets 并非仅局限文本,底层动态分块机制可迁移到其他原始信号:
- 生物 DNA 序列:直接以核苷酸作为输入原子,H‑Net 相比普通 Transformer 获得6‑7 倍算力增益,并且无监督地自动识别出基因的编码区、非编码区、密码子边界,属于完全自发涌现的生物学结构认知,没有引入生物领域先验规则。
- 视觉图像:多维 H‑Nets 直接处理像素,无需预定义 patch;可以把空间上不连续但语义同源的图像区域合并为同一个块,实现无监督语义分割,能够从 2D 图片推测潜在 3D 结构。
Cartesia 团队表示,H‑Nets 契合 AI 领域 “苦涩教训(Bitter Lesson)” 理念:优先依靠大规模数据与计算,减少人工先验与手工规则。传统分词是大模型最后几个人工设计流水线环节,H‑Nets 证明可以把分词环节交给模型本身学习,为下一代通用基础模型开辟新路径。第二篇博文将深入拆解损失‑缩放规律,进一步解析 H‑Nets 性能增益的内在机理。


