





11月2日消息,近日,来自美国宾州里海大学 Lehigh University 等机构的研究者提出 Lev,一个用循环而不是 token 来加深思考的决策模型。Lev 在每一圈之后都读出一次选项概率,各圈联合训练,所以同一份权重可以在任意深度作答;一个轻量的停止器再按题目决定算几圈。
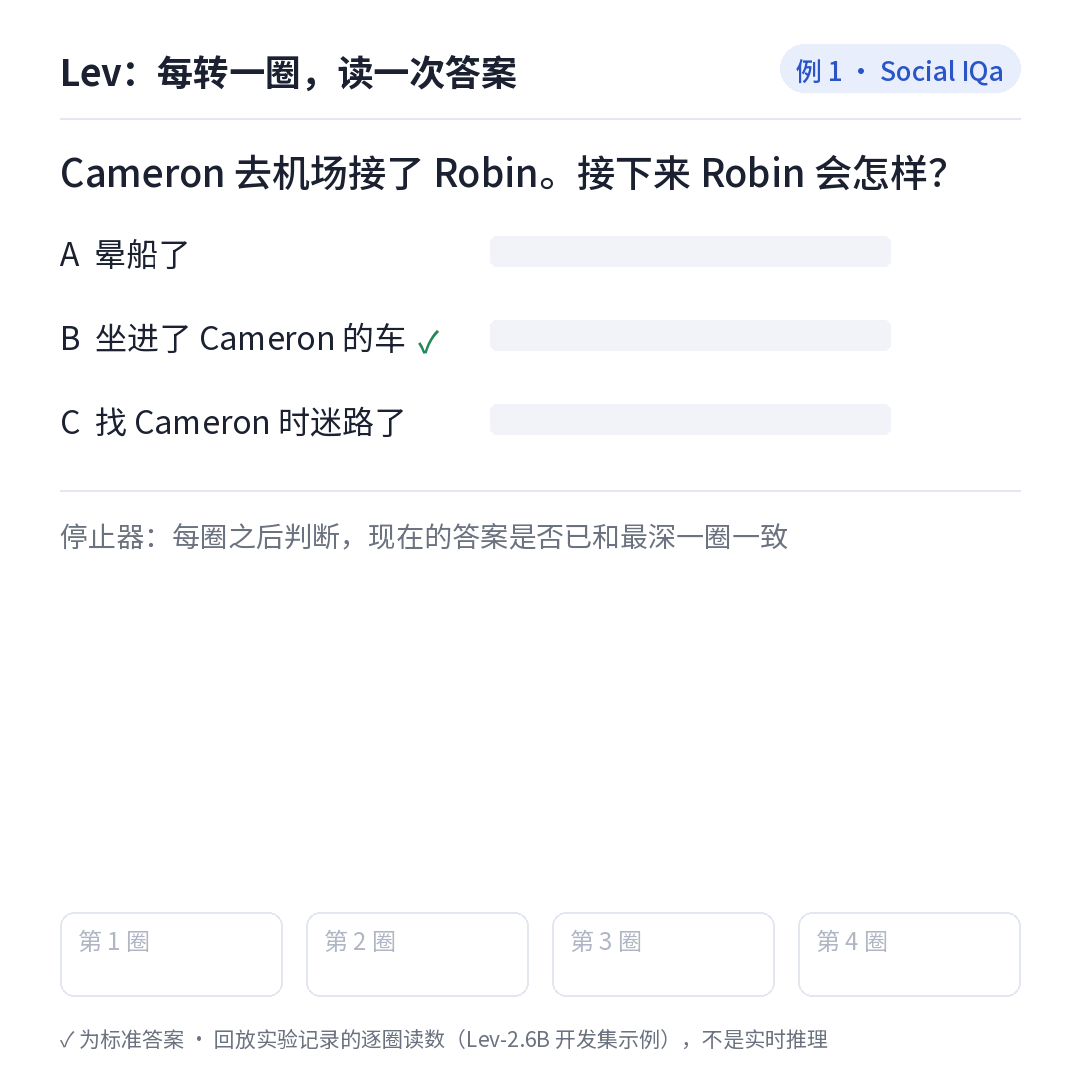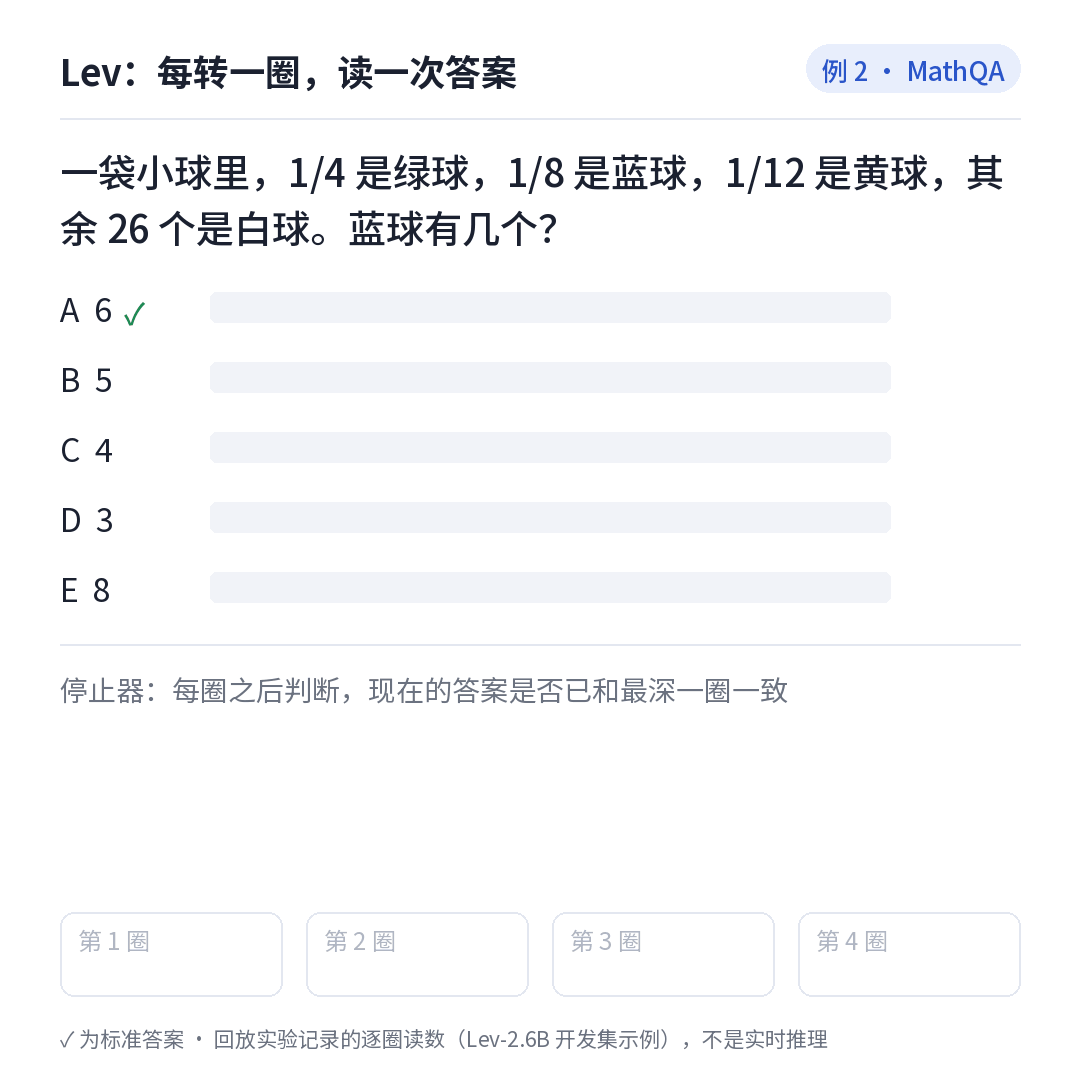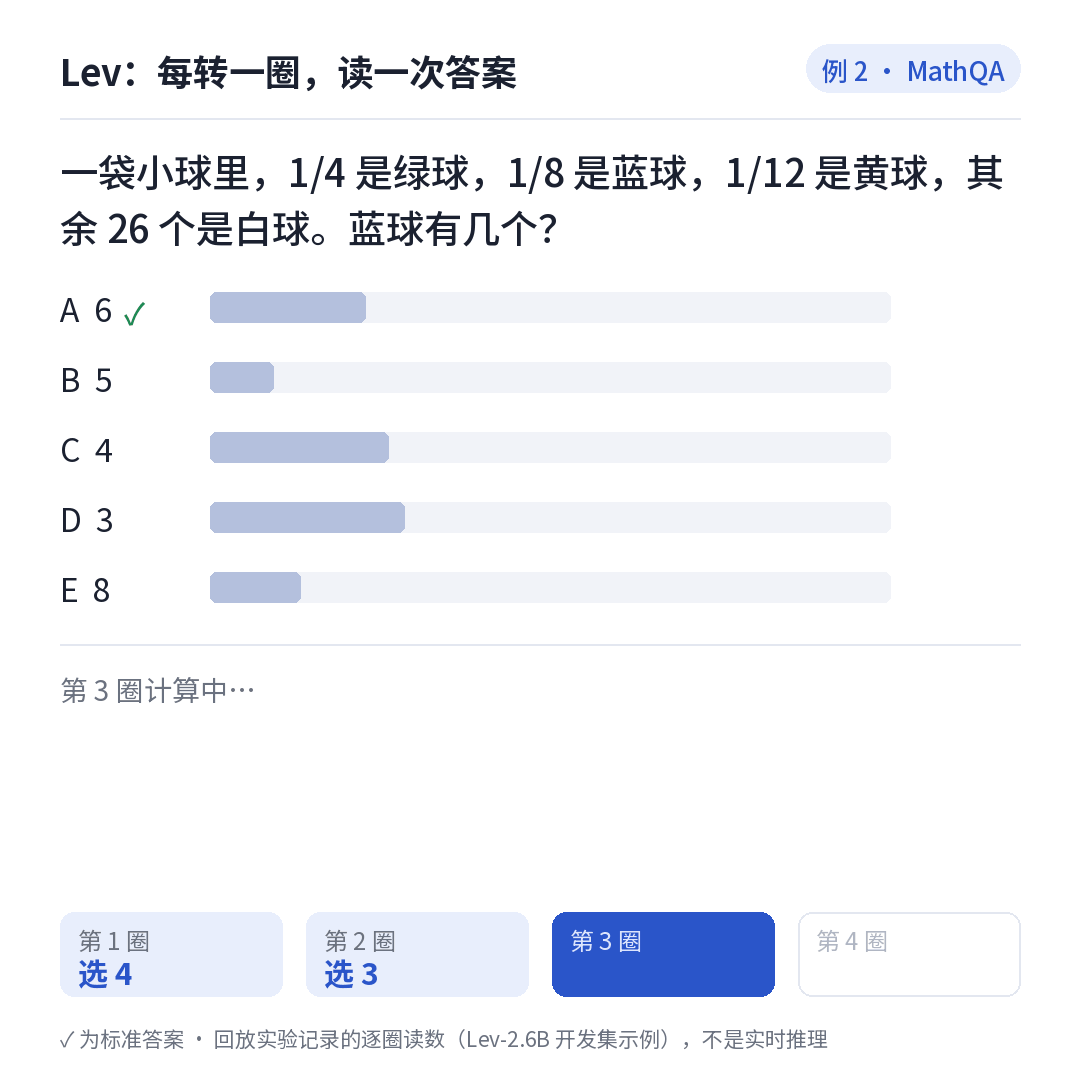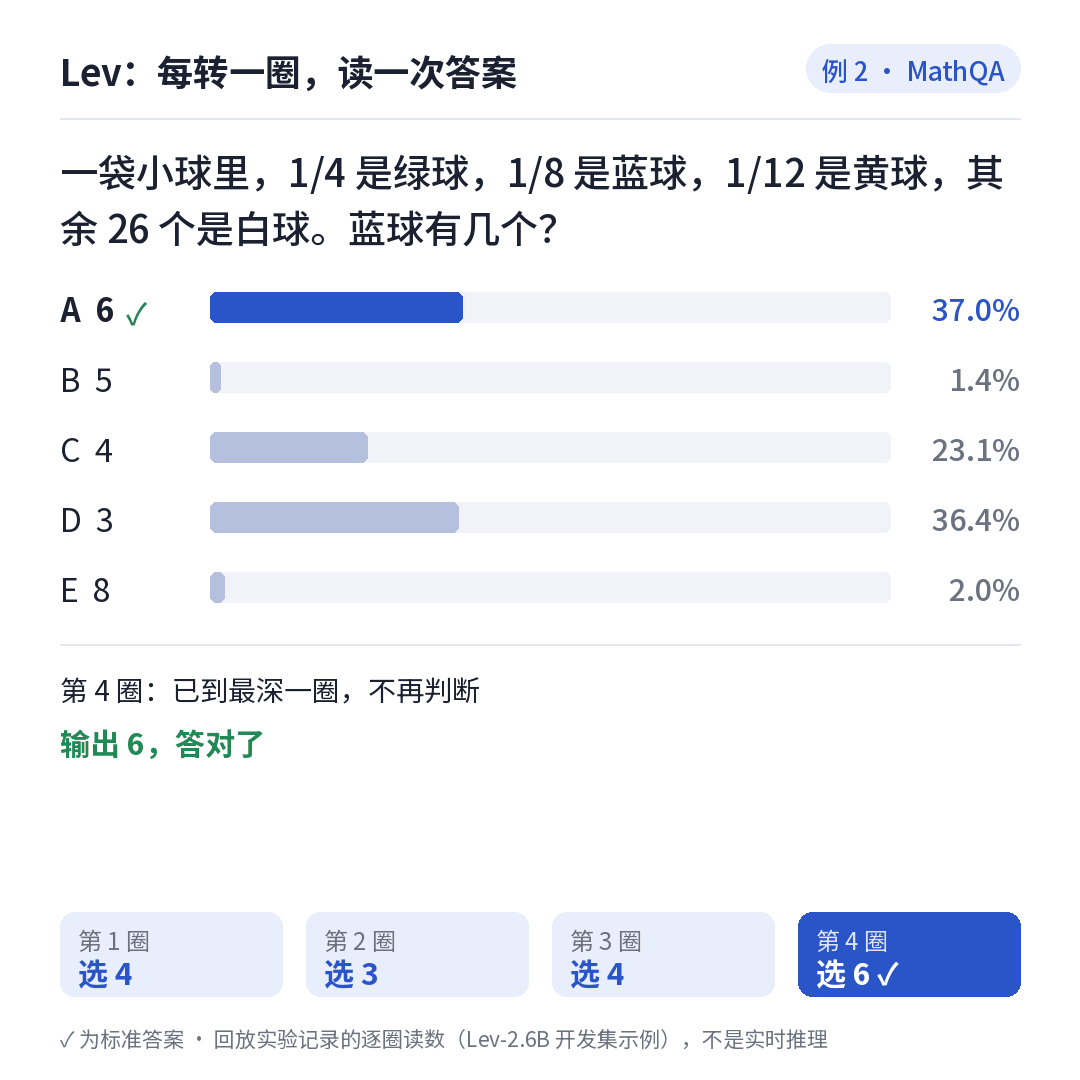
作者把这种计算方式称为 System 1.5 :保留 System 1 直接给出决定的接口,又能像 System 2 一样在难题上多花计算。
Lev 逐圈作答(按项目主页记录的逐圈读数重绘,回放实验数据,不是实时推理):例 1 第 1 圈就选中正确答案 B,停止器判定可以停下;例 2 第 1 圈选 4,到第 4 圈改选正确答案 6。
从任务形态看,Lev 可以视为 OpenAI Decisions 式文本决策的一个独立开源实现,并多了一个「深度旋钮」。这里的「式」只指任务形态:给定输入和候选项,输出每个选项的概率。Lev 基于公开的 Ouro、Nanbeige 底座和 Kev 实现,不复刻 OpenAI 的模型权重、内部架构或 API,也没有与其产品做性能对测。
在公开 JevBench 的 231 道题上,同一个 Lev-2.6B checkpoint 从一圈的 63.2% 提升到四圈的 76.2%,增加 13.0 个百分点,权重没换,变的只是循环深度。
为什么决策模型需要「按需加深」?
作者先拿两个公开的决策模型 Kev-0.8B 和 Kev-4B 做了一次逐题对比。两者用同样的数据源训练,在 JevBench 的 231 道公开题上,Kev-4B 比 Kev-0.8B 多答对 28 道,而这 28 道全部来自标准题和难题:简单题两个模型本来就全答对了。
更关键的是,两个模型只在 42 道题上结果不同,可 Kev-4B 在每一道题上都多花了参数和计算。如果用 Kev-0.8B 的置信度挑出它最没把握的一半题目交给 Kev-4B,准确率就几乎追平 Kev-4B 全量作答。
换句话说,额外计算只在少数题上有用,而一次便宜的初读就能找到这些题。
Lev 怎么做:每一圈都能读出答案
Lev 沿用 Kev 的决策模型接口。一个请求包含一段状态(例如一段对话或一份文档)和若干问题,每个问题列出自己的候选项。所有内容打包成一条序列,用块因果掩码让每个问题只看到状态和自己,这样状态只编码一次,每个问题又像单独提问一样作答。
不同之处在于底座:Lev 换成了原生循环语言模型 Ouro 或 Nanbeige4.2。同一组解码层重复运行 R 次,每一圈之后,同一个 pointer head 读取各选项结束符和 位置的隐藏状态,输出一次选项概率。
训练时,pointer head 和 LoRA 适配器在各圈之间共享,损失对所有圈取平均,所以每一个深度都被训练成一个可用的决策模型,而不只是最后一圈。
这带来两个直接好处。第一,第 t 圈只依赖前面的圈,用 k 圈服务时只算前 k 圈,成本约为全深度的 k/R。第二,「再算一圈」就是从上一圈的隐藏状态继续往下算,请求不需要重新读一遍,这正是级联做不到的。
此外,浅层和深层读出的校准程度不同,作者为每个深度单独拟合一个温度。温度缩放不改变预测选项,所以不影响准确率。


