





11月2日消息,近日,来自 DeepMind 研究所,集合计算机科学、神经科学、哲学领域共 14 位研究者的合著书籍《Assessing AI Consciousness: From Cacophony to Hierarchy》(《评估 AI 意识:从众说纷纭到层级框架》)正式出版,该书试图跳出纯粹哲学思辨,提供一套可落地、可量化的评估范式,用来判断 AI 系统是否具备意识。
本书已于全球亚马逊上架,2026 年 11 月 7 日起将进入全球实体书店渠道销售。
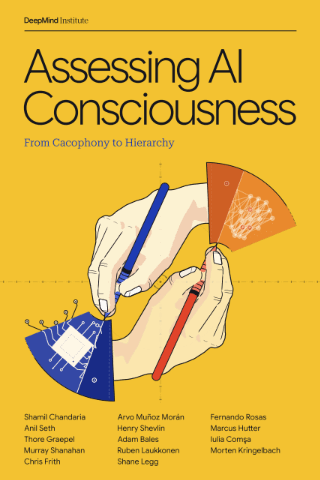
参与本书创作的作者阵容强大,包括Google DeepMind联合创始人兼首席AGI科学家肖恩·莱格(Shane Legg)、DeepMind高级研究员马库斯·哈特(Marcus Hutter)、英国萨塞克斯大学认知与计算神经科学教授阿尼尔·塞斯(Anil Seth)、DeepMind首席科学家Murray Shanahan 等知名学者。
当前行业面对 AI 意识最大困境在于:不同专家不仅对 “现有大模型有没有意识” 结论完全对立,连意识本身依赖什么样的系统条件都没有统一理论,公众又很容易凭借 AI 拟人化行为本能地赋予机器心智,造成大量主观判断与争论。
该书并不追求直接给出 “AI 有意识 / 无意识” 的终极答案,而是把复杂问题做拆解:将形而上学层面的 “意识难问题” 搁置,转而聚焦 “映射问题”—— 即系统哪些组织特征会对应主观体验。
基于 Marr 经典三层分析理论,作者拓展出五层功能描述层级体系,把主流各派意识理论安放至这套层级框架之内;再引入贝叶斯评估模型,把评估拆分为两大独立部分:一是研究者对不同意识理论的主观置信度,二是 AI 系统可观测的实证指标证据,二者结合输出系统具备意识的综合置信概率arXiv。
书中演示评估显示,对于同一套大语言模型,仅仅调整理论假设权重,最终算出的意识置信度可以相差接近两个数量级。作者认为这种巨大差异不是模型缺陷,恰恰反映现实:AI 意识判断结果高度依赖研究者采信哪一套意识理论。这套框架的价值,是让各方分歧变得清晰可辩论,明确到底是理论前提不一样,还是对实证证据解读不同,同时随着新证据出现可以迭代更新评估结果。
为方便社区复用,项目同步开源全套配套资产:公开代码仓库、交互式在线评估工具、配套 PPT 讲义与公开演讲视频,研究人员可以直接运行这套评估模型,对不同 AI 系统做测算检验。
书中同时提醒,意识不等于智能,但通用人工智能所需要的部分架构特征,恰好和诸多意识理论提出的指标重合;未来随着 AI 能力迭代,会有越来越多指标被满足,这套框架可以反复复用评估新一代系统。


