





11月3日消息,近日,港科大联合微软研究团队发布业内首个面向真实数据库的原生长程交互 SQL Agent 训练框架HarnessSQL,并完成全部代码、沙盒环境与轨迹数据集开源。
实测中,8B 参数模型性能实现对 32B 级别专用 SQL 大模型的反超,为解决大模型 Text‑to‑SQL“训练‑部署脱节” 行业痛点给出新方案。
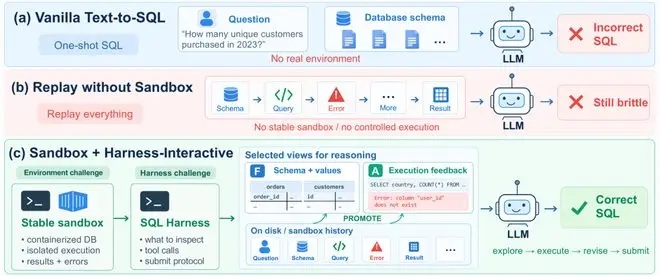
在企业真实数据分析场景中,传统 Text‑to‑SQL 方案大多采用单轮生成模式:输入自然语言问题和静态数据表结构,直接输出 SQL 语句。但现实业务数据库往往拥有上百张数据表、数千字段,数据体量庞大。
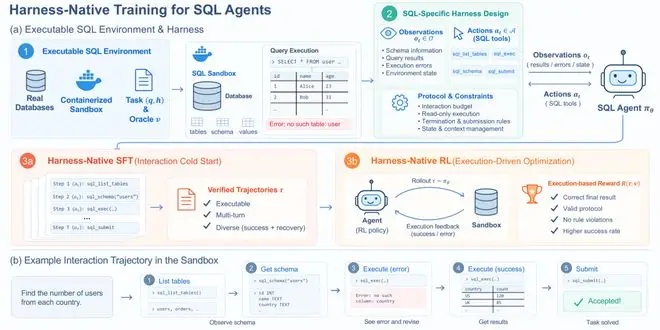
专业分析师处理业务时,并不会直接编写最终 SQL,而是先查看表清单、探查字段结构、执行试探查询,再依据报错反复调试。
传统静态微调的大模型缺少这套探索试错流程,在 Spider2.0、BIRD‑Interact、LiveSQLBench 等交互评测基准上缺陷凸显:模型只会输出 “标准答案”,进入真实交互环境后,不具备状态追踪、错误恢复能力,容易陷入死循环或者直接崩溃,也就是行业所说的训练与部署脱节(Train‑Deploy Mismatch)。
针对该难题,研究团队将交互式 Text‑to‑SQL 任务抽象为部分可观测马尔可夫决策过程 (POMDP),搭建密闭沙盒执行环境,设计 SQL 专属交互契约 DSH‑SQL,并且提出 “长程轨迹监督微调 (SFT)+ 执行奖励强化学习 (RL)” 两阶段训练流水线。
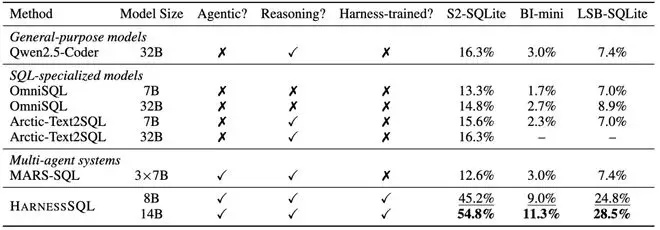
研究团队在三大交互数据库基准开展对比测试,对比对象包含通用代码大模型、专用 SQL 模型、多智能体系统,统一以执行准确率作为评价指标。
在 Spider 2.0‑SQLite 基准下,HarnessSQL‑8B 取得 45.2% 执行准确率,是同底座基线的近 3 倍,显著优于 OmniSQL‑32B、Arctic‑Text2SQL‑32B、Qwen2.5‑Coder‑32B 等 32B 级别模型;底座升级至 Qwen3‑14B 后,准确率进一步提升至 54.8%。
域外泛化测试同样表现亮眼。在 BIRD‑Interact Mini、LiveSQLBench 跨领域基准中,HarnessSQL‑8B、14B 的指标达到 32B 基线模型的 3‑4 倍,证明模型学到通用数据库探索策略,并非简单记忆数据表 Schema 信息。
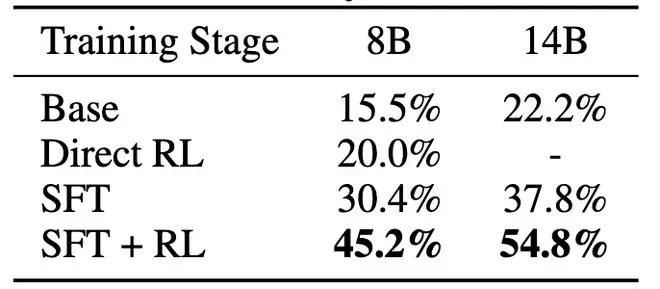
受控消融实验验证了长程 SQL Agent 最优训练范式:仅做强化学习冷启动收益很低;先通过全轨迹 SFT 学习交互范式,再叠加 DAPO 强化学习,才能实现性能质变。
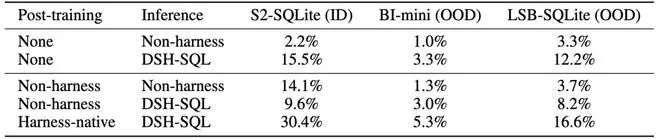
同时实验得出多项关键结论:训练环境和推理环境必须严格对齐;完整交互轨迹训练效果远优于样本单步拆分;更大的上下文窗口是长程探查任务的关键;DAPO 算法相比 GRPO、GSPO,更适配长程任务的稀疏奖励优化场景。


