





(文/杨亮)11月10日消息,近日,LongCat‑2.5 正式对外开源,模型采用 MIT 开源协议,允许商用推理部署以及二次训练,无需额外授权。该模型定位面向长程智能体任务的原生多模态大模型,总参数规模达 1.6 万亿,单 token 激活约 480 亿参数,支持一百万 token 超长上下文,针对显存、带宽受限的国产算力芯片完成架构、算子、部署策略的深度适配优化。
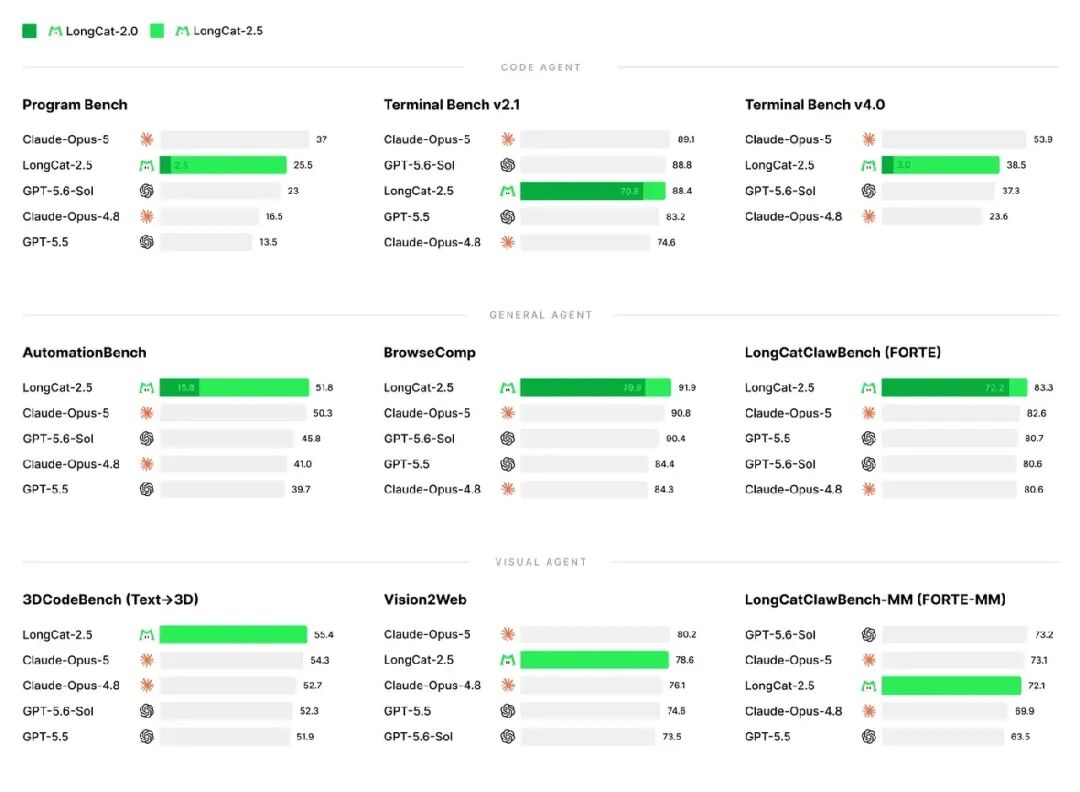
据介绍,LongCat‑2.5 在复杂代码库开发、完整项目搭建、Visual Coding 视觉编程、专业办公等场景,端到端任务交付能力获得显著提升。其长程智能体能力并非依靠单点调优,而是整套训练链路协同升级。
训练环节引入大量真实长程任务轨迹,将智能体执行失败样本转化为可复现训练任务;采用 partial rollout 异步强化学习训练机制,动态调整过采样率,对历史轨迹做梯度校正,减少陈旧偏差;同时增设多重训练约束,通过环境管控、LLM 监督,抑制模型重复思考、无效工具调用等 “钻空子” 行为,保障长任务稳定执行。
视觉能力层面,LongCat‑2.5 摒弃外挂视觉模块方案,把视觉信号转化为多层级离散 token,图像与文本共用同一主干模型、共享语义空间。原生分辨率视觉特征做残差向量量化,逐级还原细节;视觉 token 支持离线预计算缓存,降低线上推理开销,也让分布式训练负载更加均衡,可完成创意设计、3D 生成等视觉编码任务。
在专业办公场景,模型能够同时处理多份文档资料,提炼关键信息输出专业判断,端到端生成报告、演示文稿等交付物。团队通过多专家在线教学、Tree Attention、大规模智能体强化学习等配套技术,进一步强化跨任务泛化能力,无需针对办公场景单独定制模型。
推理落地方面,LongCat‑2.5 落地 W4A4 量化推理方案,将专家权重、激活值同时压缩至 4bit,依托 INT4 矩阵乘法单元运算。基于 FlatQuant 可学习等价变换优化 MoE 量化精度,下游任务效果基本与量化前持平。
通过算子融合、权重布局优化、计算通信流水重叠等手段,减少数据搬运开销,为万亿级 MoE 模型开源部署提供高效率方案。
针对国产算力单卡显存不足 80GB 的现实约束,项目采用 FSDP 双重分片、混合词表并行等技术分散显存压力;借助拓扑感知并行策略,把大量通信限定在超节点高带宽互联域,搭配 MoonEP 动态专家复制、零拷贝通信等机制,实现长序列训练与微调。
实测长序列 SFT 任务中,单卡吞吐量相比 DDP 基线提升 86%,证明万亿参数 MoE 模型在国产算力上可高效完成长序列训练,为行业社区复现、二次开发提供工程参考路径。
项目团队表示,选择 MIT 协议,意在降低使用门槛,鼓励社区自由使用、修改、再分发模型。国产算力是长期投入方向,万亿参数模型落地需要在架构、量化、并行通信之间反复权衡,依靠芯片、框架、应用多方磨合推进生态成熟。后续团队将持续开放模型与工程经验,推动产业技术迭代。


